从 AI Workflow 到平台内核:xHalo 现阶段总体架构复盘
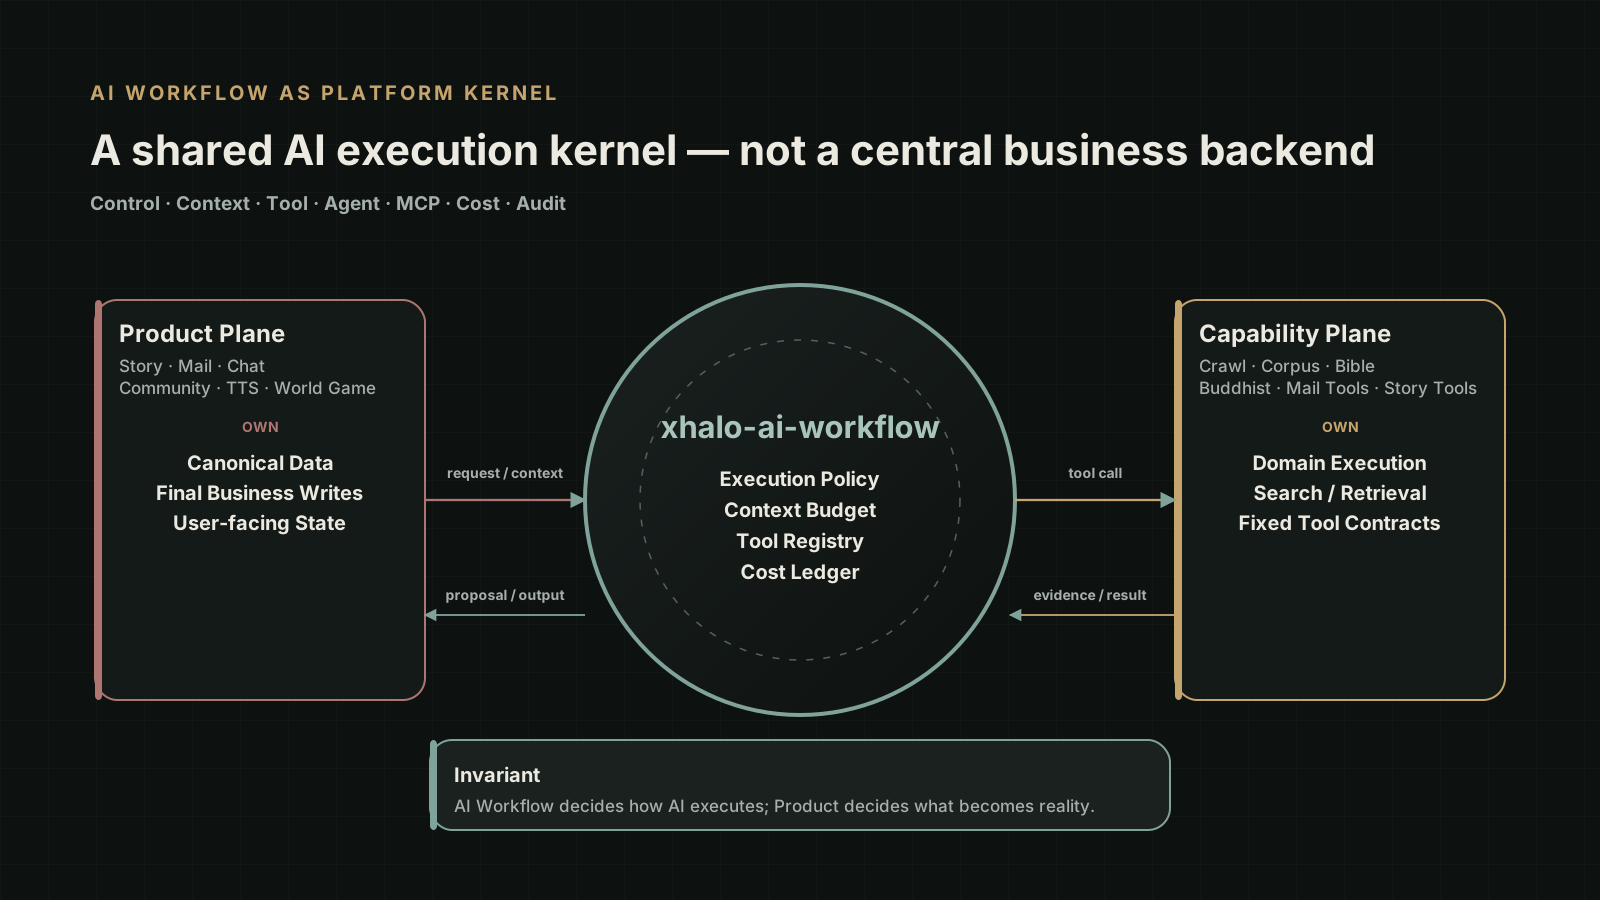
过去几个月,xHalo 的变化并不只是“又多了几个项目”。如果仍然按照仓库列表去理解它,会看到越来越多的 Worker、API、Reader、Admin 页面和数据服务;但从架构角度看,真正发生的变化是:原本彼此相对独立的产品能力,开始围绕一个共享的 AI 控制与执行平面重新组织。
这个中心就是 xhalo-ai-workflow。
它最初只是为了解决模型调用、Prompt、Gateway 和 Workflow 分散的问题,后来逐步补上成本账本、幂等状态机、Tool Registry、RAG Evidence、Context Engineering、Agent Boundary 和 MCP Export。到了现在,它已经不再适合被定义为“统一模型调用服务”,更准确的定位应该是:
xHalo 的 AI Control & Execution Plane——负责决定 AI 如何执行、可以使用什么能力、消耗多少上下文和成本、如何留下可追踪证据,但不拥有最终业务事实。
这次复盘以 2026 年 8 月下旬的现阶段实现 为基线,重点不是继续描述未来愿景,而是回答四个问题:现在的 xHalo 到底已经形成了怎样的总体架构;ai-workflow 与各模块的真实关系是什么;这一套架构是怎样一步步演进出来的;哪些地方已经做对,哪些地方已经开始暴露新的平台治理问题。
一、先改变看 xHalo 的方式:它已经不是仓库清单
如果按仓库看 xHalo,很容易得到类似下面的印象:
1 | xhalo-auth |
这种视角适合管理代码,却不适合解释系统。
现阶段更合理的方式,是把这些仓库放回 六个逻辑平面:
- Experience / Product Plane:真正面对用户,并拥有最终业务状态;
- Identity & Access Plane:统一身份、Session、OAuth、Entitlement 和多端身份契约;
- AI Control & Execution Plane:模型、Prompt、Workflow、Context、Tool、Agent、MCP、成本和运行追踪;
- Capability / Tool Plane:抓取、搜索、邮件、知识检索、叙事操作等可被调用的能力;
- Canonical Data / Knowledge Plane:各领域自己的权威数据、索引、业务状态与知识库;
- Infrastructure Plane:Cloudflare 与 VPS/PostgreSQL 等底层资源。
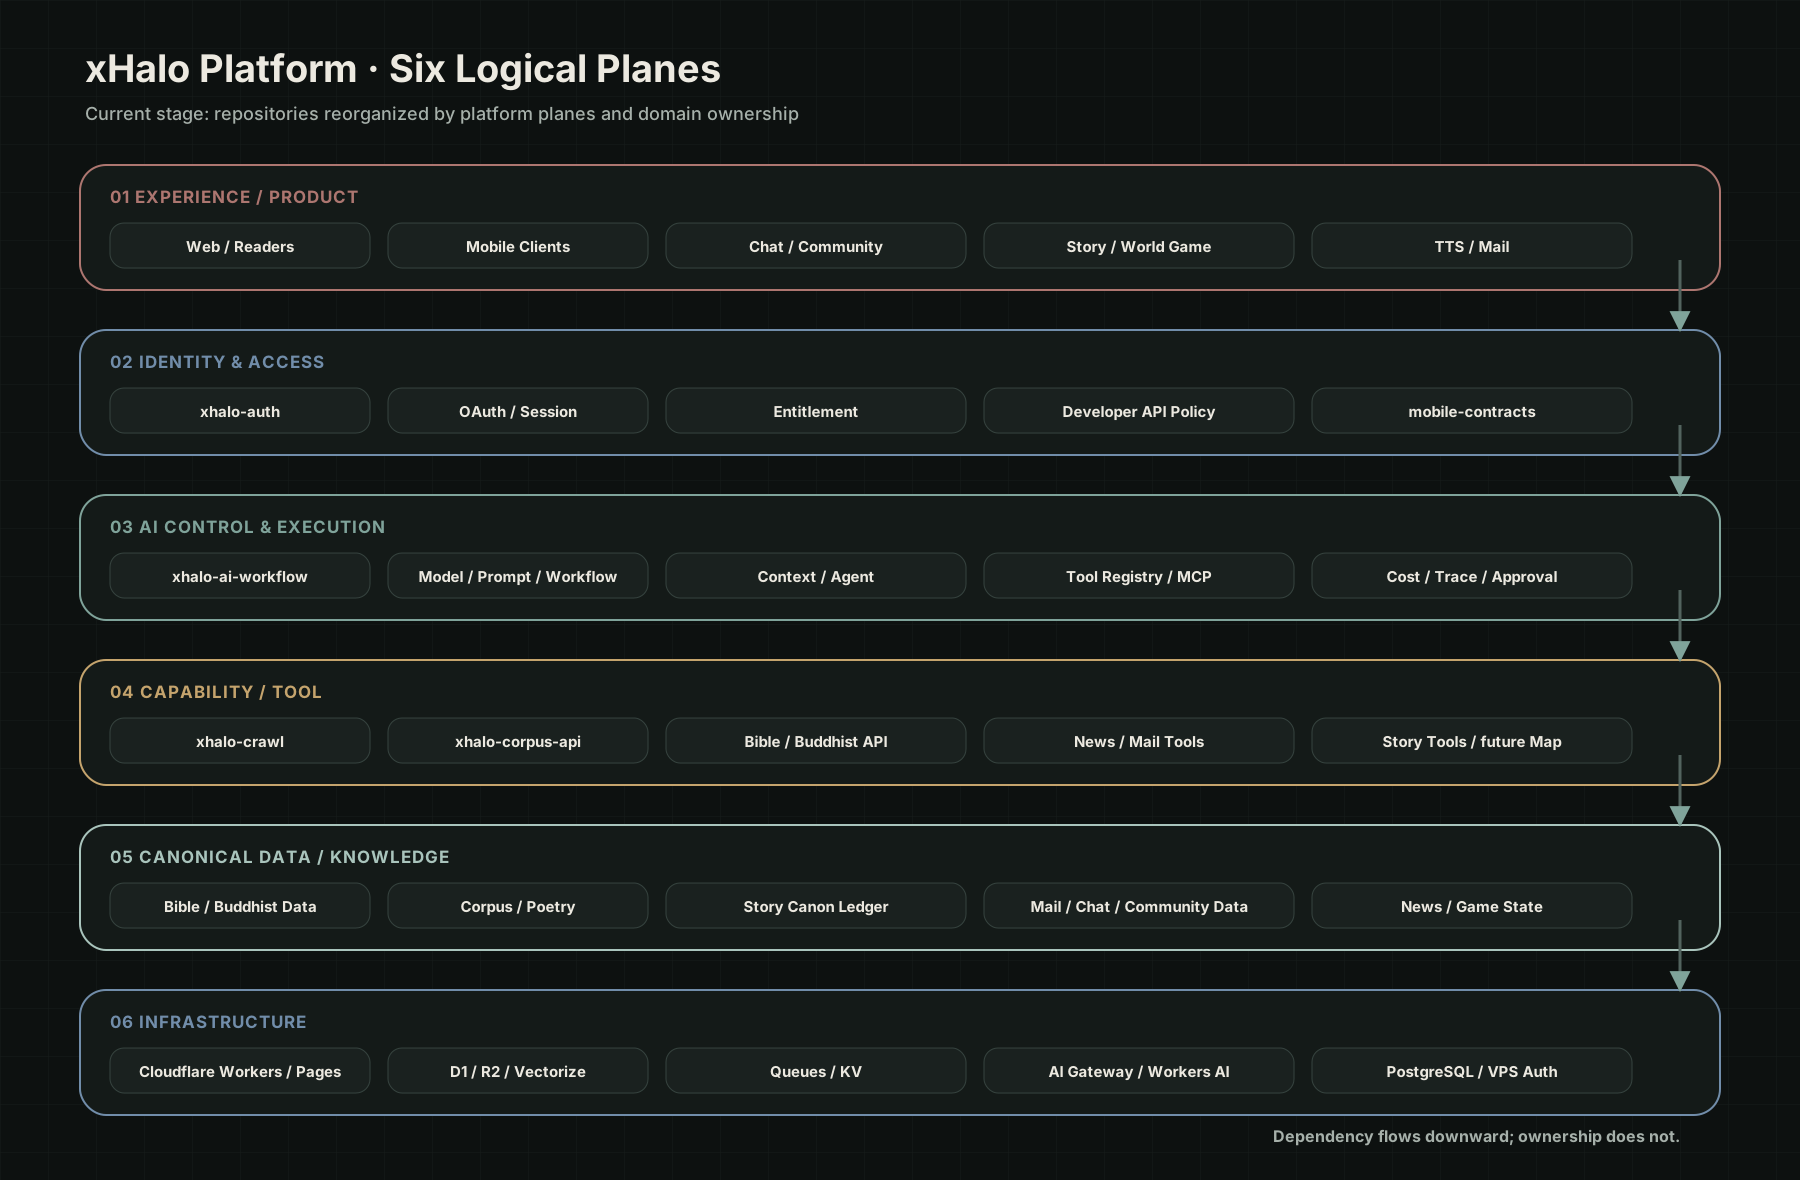
这张图里最重要的并不是“谁调用谁”,而是 谁拥有什么。
xHalo 目前最有价值的一条架构原则,是没有为了“统一”把所有业务数据、队列和状态都搬到 xhalo-ai-workflow。产品仍然拥有自己的 conversation、content、mailbox、story canon、game state 和最终写入;Bible、Buddhist、Corpus 等知识服务仍然拥有自己的 canonical data 和检索基础设施;Admin 负责配置和观察,但不承担模型执行;AI Workflow 负责共享执行规则,而不是成为所有项目的中央数据库。
这使得 xHalo 正在形成的是一个 平台化的多服务系统,而不是一个不断膨胀的超级后端。
二、AI Workflow 的真正定位:平台内核,而不是中央业务服务
现阶段可以把 xhalo-ai-workflow 简化成一句话:
它决定 AI 怎样工作,但不决定业务世界最终变成什么样。
例如 Story 请求生成一段场景时,AI Workflow 可以决定使用哪个 Workflow、哪个 Prompt、哪个 Model Alias、允许调用哪些 Tool、Context 上限是多少、成本是否允许、是否需要 Validation;但生成结果是否进入 Story 的 Canonical Commit Ledger,仍然由 Story 自己决定。
Mail 也是一样:AI Workflow 可以完成摘要、分类、操作建议或回复草稿,但 mailbox ACL、draft ownership、最终发送动作仍然属于 Mail Domain。
因此理想的数据流不是:
1 | Product → AI Workflow → 直接修改产品数据库 |
而是:
1 | Product |
这条边界是整个系统能否继续扩展的关键。
2.1 AI Workflow 内部现在已经包含什么
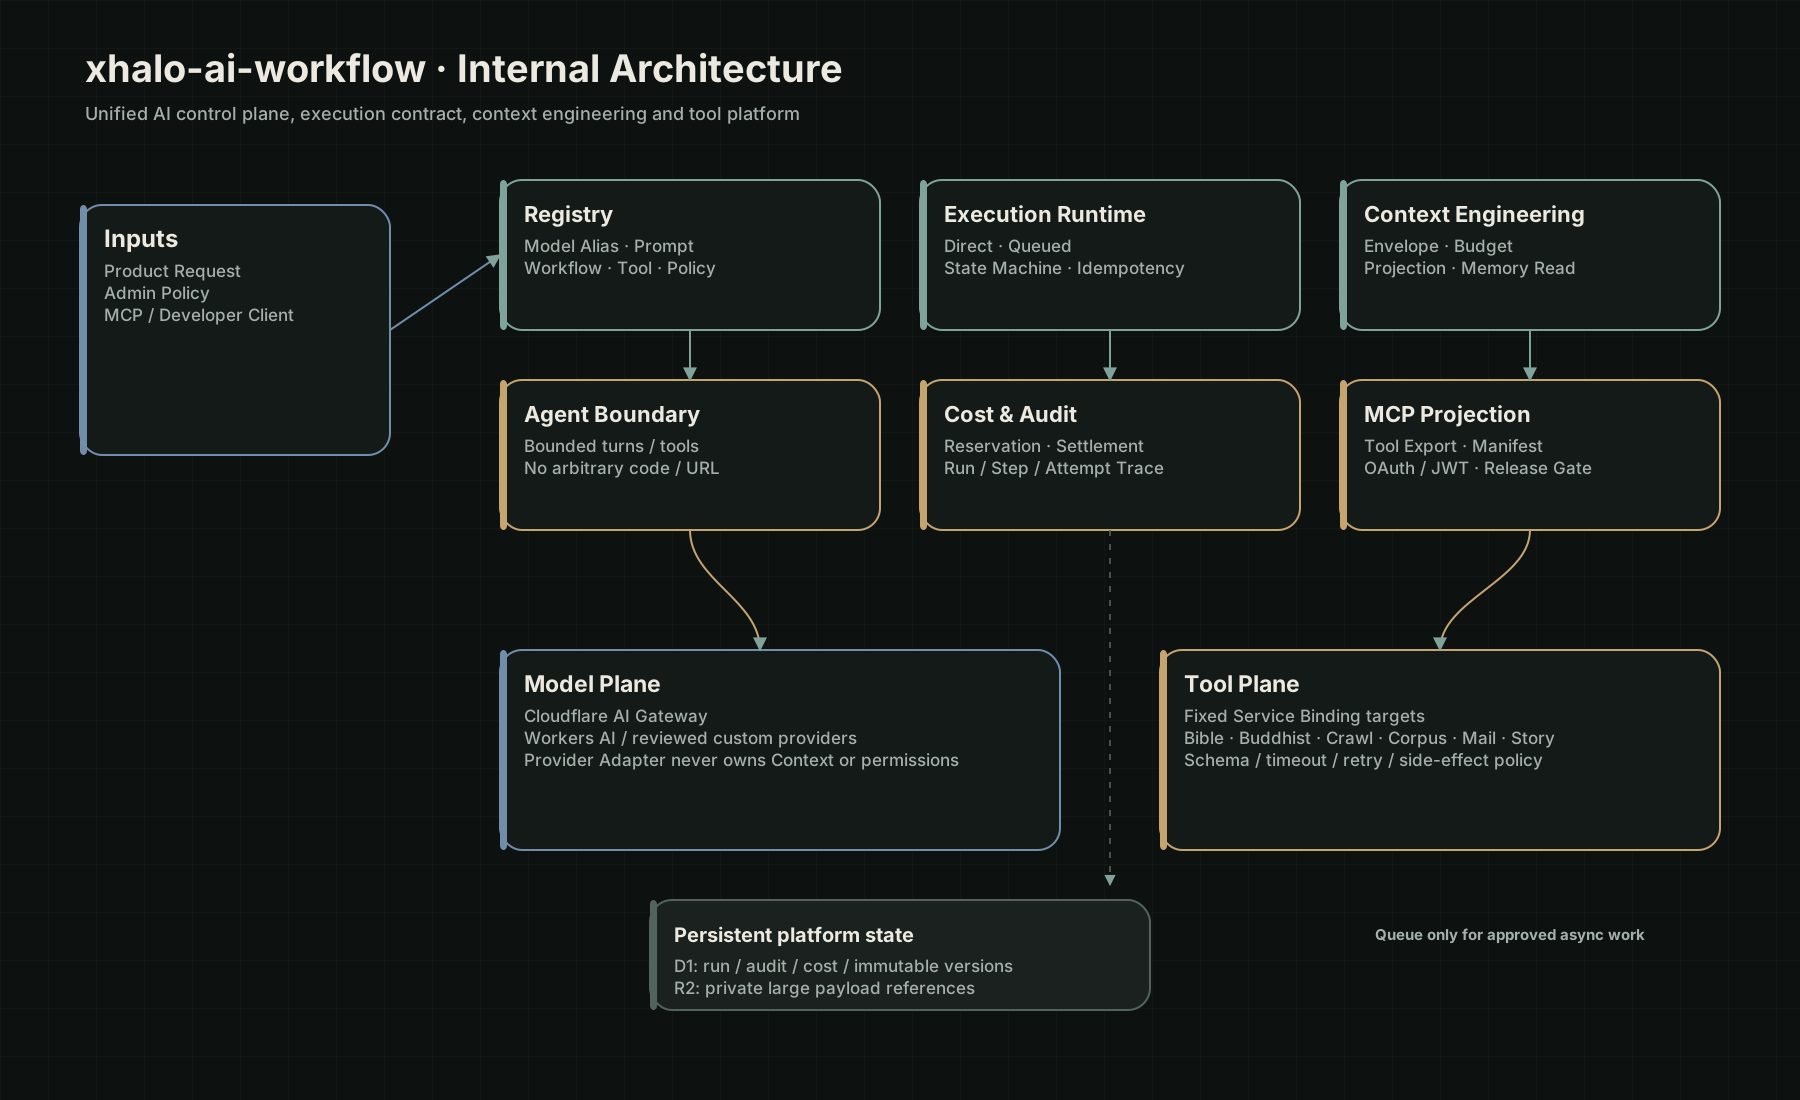
从当前职责看,它已经形成几个相对清晰的内部子系统。
Registry
负责版本化描述:
- Gateway / Model;
- Model Alias;
- Prompt;
- Workflow;
- Tool Definition;
- Route / Budget / Policy。
这些对象越来越强调 Version + Immutable + Snapshot。一个已经发布并被 Run 使用的定义,不应该在原地修改;Replay 也应该优先复用原来的依赖版本,而不是默默使用当前最新配置。
Execution Runtime
负责:
- Direct Run;
- 有条件的 Queue/Async;
- Run / Step State Machine;
- Idempotency;
- Retry Boundary;
- Replay / Recovery;
- Approval Boundary。
这里一个重要的设计选择是:不是所有任务都为了“统一”而强制进入中央 Queue。 产品本来已经拥有 Queue 的场景,仍然可以由 Product Queue 管业务交付重试,再调用 AI Workflow 执行模型任务;只有真正适合长任务、审批或平台异步执行的能力,才进入中央执行路径。
Context Engineering
这是 7 月底之后 AI Workflow 发生质变的一层:
- Context Envelope;
- Context / Cost Budget;
- Tool Result Projection;
- 大结果 Reference;
- Caller-provided bounded context;
- Memory Read;
- Deterministic Tool Discovery;
- Provider Capability Adapter。
它意味着系统不再只是问“调用哪个模型”,而开始问:这次执行到底允许模型看到什么、保留什么、引用什么,以及如何控制上下文放大。
Tool & Agent Boundary
Tool Registry 负责把外部能力变成受约束的执行契约,包括:
- 固定 Owner;
- 固定 Transport / Service Binding;
- 固定版本;
- Input / Output Schema;
- Timeout;
- Retry;
- Max Response;
- Data Classification;
- Side Effect Level。
Agent 则只能在这些已发布、已允许的 Tool 范围内工作。现阶段刻意避免任意 URL、任意 DB、任意 JavaScript、Shell 或自由代码执行,这比“先把 Agent 做强,再补安全”更适合平台长期演进。
Cost & Audit
模型成本现在不应该继续由各产品分别估计美元成本。Product 可以管理“用户能用几次”“什么套餐能用”“是否处于冷却期”,但 Provider Money Budget、Reservation、Settlement、Release、Model Attempt 和 Cost Ledger 属于 AI Workflow。
这使未来不同产品共用模型时,仍然可以得到统一的成本归因。
MCP Projection
MCP 并不是另外一套 Tool 系统,而是 Tool Registry 的外部投影:
1 | Tool Definition |
这使同一个能力未来可以同时被 Product、Agent、MCP 和 Developer API 使用,而不必维护四套完全独立的业务定义。
三、Identity 与 Control Plane:Auth 和 Admin 为什么必须继续分开
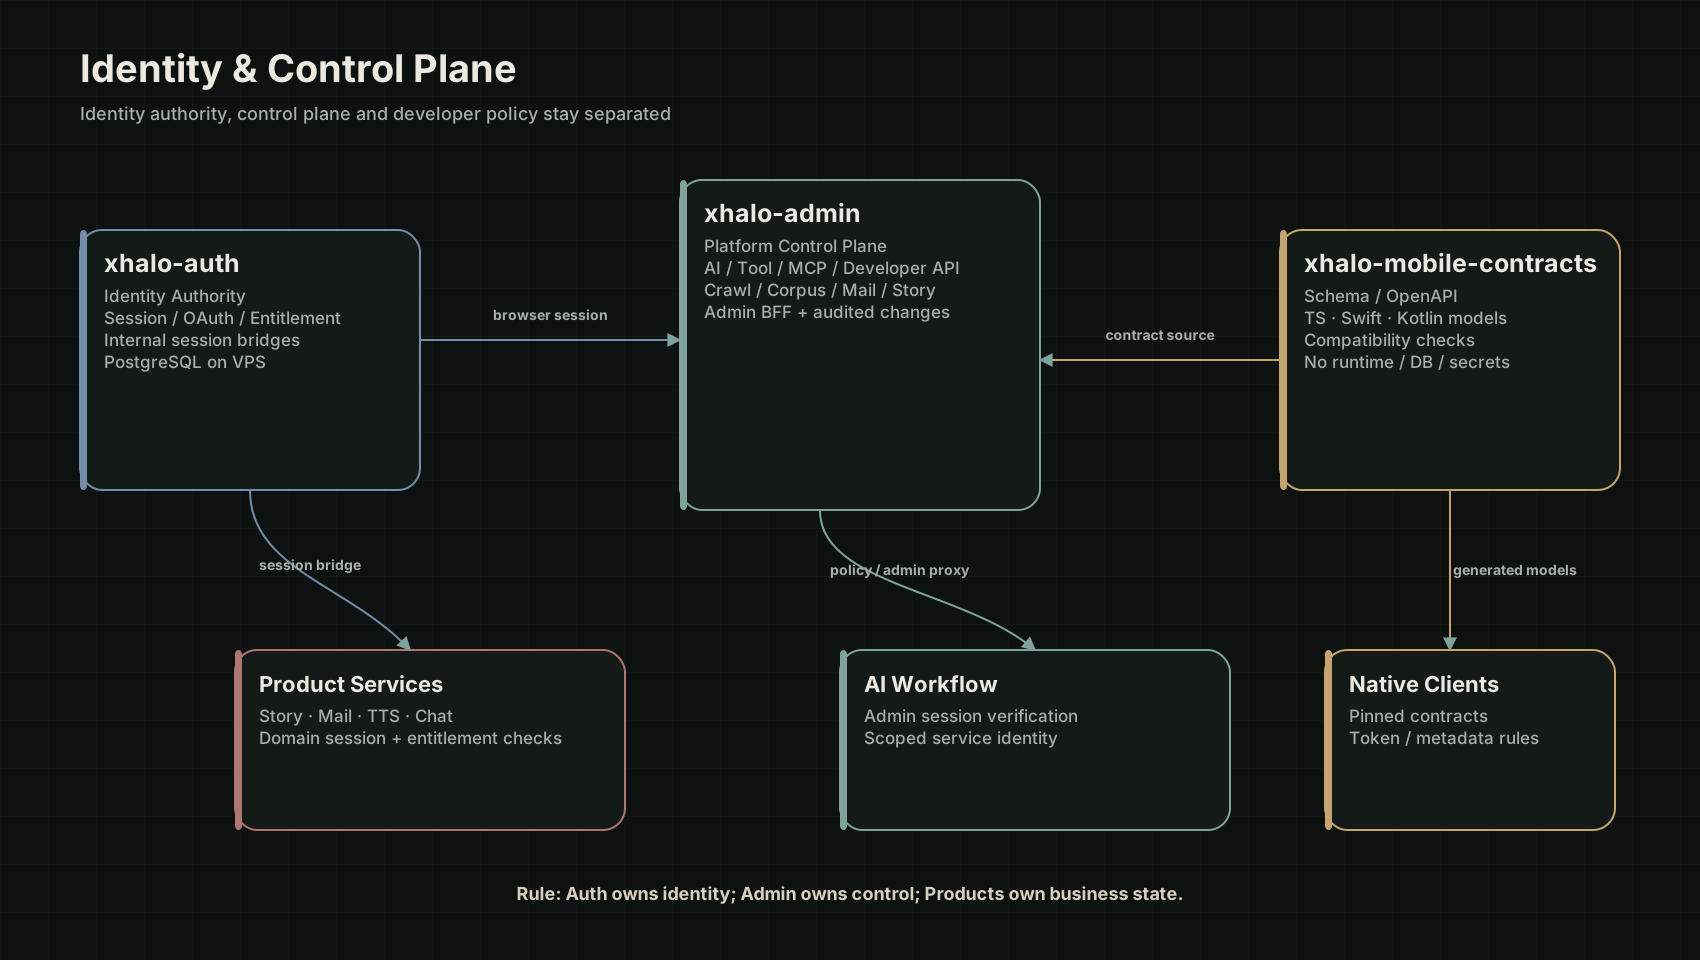
3.1 xhalo-auth:身份权威,而不是业务后台
xhalo-auth 当前仍然是独立的 Identity Authority,运行时保留在 VPS + PostgreSQL 体系中,主要负责:
- 登录、注册和账号状态;
- Browser Session;
- OAuth;
- Entitlement;
- 内部 Session Bridge;
- 后续 Mobile Token / Device Session 契约。
一个很重要的边界是:Auth 只返回“你是谁、账号是否有效、有什么资格”,不应该逐渐变成 Mail、Story、TTS 等业务数据的共享数据库。
内部的 ai-workflow/session、story/session、mail/session、tts/session 等桥接接口,本质上都在做同一件事:把平台身份投影给 Domain Service,而不是代替 Domain Service 做业务授权。
3.2 xhalo-admin:越来越像真正的 Platform Control Plane
xhalo-admin 已经不再只是一个网站后台。它现在逐渐承担:
- AI Gateway / Model / Prompt / Workflow 管理;
- Context / Tool / Agent / MCP 管理;
- Developer API Key / Scope / Policy;
- Crawl、Corpus、Mail、Story 等产品的管理入口;
- Usage / Cost / Audit / Analytics;
- Preview / Production 能力状态与发布控制。
因此它的长期定位应该明确为:
1 | xhalo-admin = Platform Control Plane UI + Admin BFF |
而不是把业务执行逻辑也放进去。
Admin 可以“配置、审核、观察、发布策略”,但不应该成为“真正调用模型并写入产品状态”的地方。
3.3 mobile-contracts:一个很小但很关键的变化
xhalo-mobile-contracts 的价值不在代码量,而在架构方向:移动端开始拥有独立版本的 JSON Schema、OpenAPI component 和 TypeScript / Swift / Kotlin 生成模型,并要求消费者 pin tag 或 commit,而不是跟随一个可变的 main。
这意味着 xHalo 正在从“Web 项目共享 TypeScript 类型”迈向真正的 跨语言 Contract Governance。
四、Capability 与 Knowledge Plane:能力应该被调用,不应该被吸进 AI Workflow
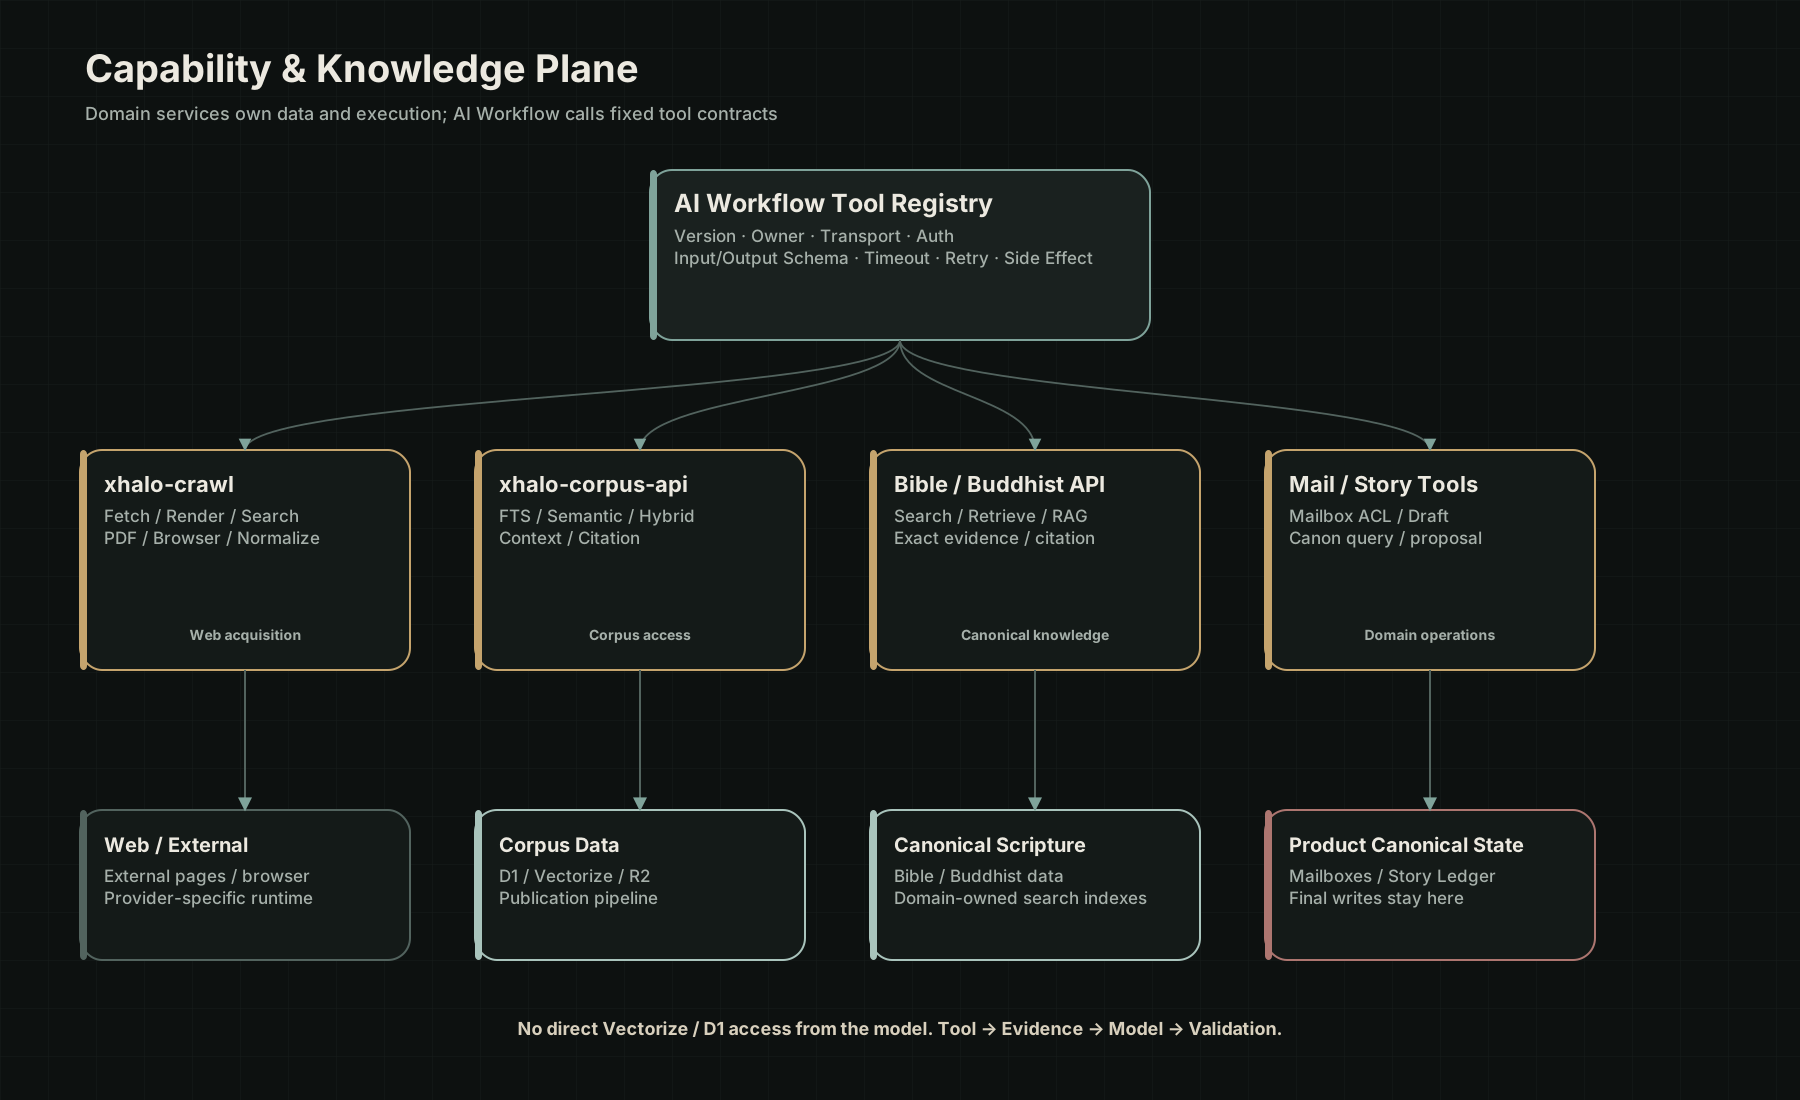
这一层是 xHalo 当前另一个做得比较正确的地方。
4.1 xhalo-crawl:标准 Capability Service
xhalo-crawl 已经形成清晰的 Provider Router:Direct Fetch、Browser Run、Stagehand、Crawl4AI、Scrapling fallback,以及统一的 Defuddle normalization、Search 和 PDF 路由。
它负责的是:
1 | URL / Query |
它不应该拥有 MCP OAuth,不应该自己再做一套 Agent Runtime,也不应该发行 Developer API Key。它只需要暴露稳定 REST / Tool Contract,然后由平台层决定谁可以调用。
这也是未来 Map、Image、Shortlink、Computer 等能力比较适合遵循的模式。
4.2 Bible / Buddhist:Canonical Knowledge 仍然属于 Domain
Bible/Buddhist 的正确做法不是把 Vectorize 或 D1 直接绑定给 AI Workflow,而是:
1 | AI Workflow |
模型拿到的是经过 Domain API 输出的 Evidence,而不是“自己去数据库里找点东西”。
这使 Citation Validation、Reader URL、Fingerprint 和数据版本能够保持可验证。
4.3 Corpus:从单一经文知识向通用知识平台扩展
xhalo-corpus-api 把 Poetry 作为参考实现,开始抽象:
- Browse / Retrieve;
- FTS;
- Semantic Search;
- Hybrid Search;
- Context;
- Citation Validate;
- Corpus Submit / Job。
这一步很重要,因为它说明 Bible/Buddhist RAG 不再是孤立特例,而是在逐渐形成一个可以承载诗歌、古典文学、小说、剧本以及后续心理学、哲学文本的通用 Corpus Pattern。
五、产品层:共享 Runtime,但必须保留不同的 Domain Authority
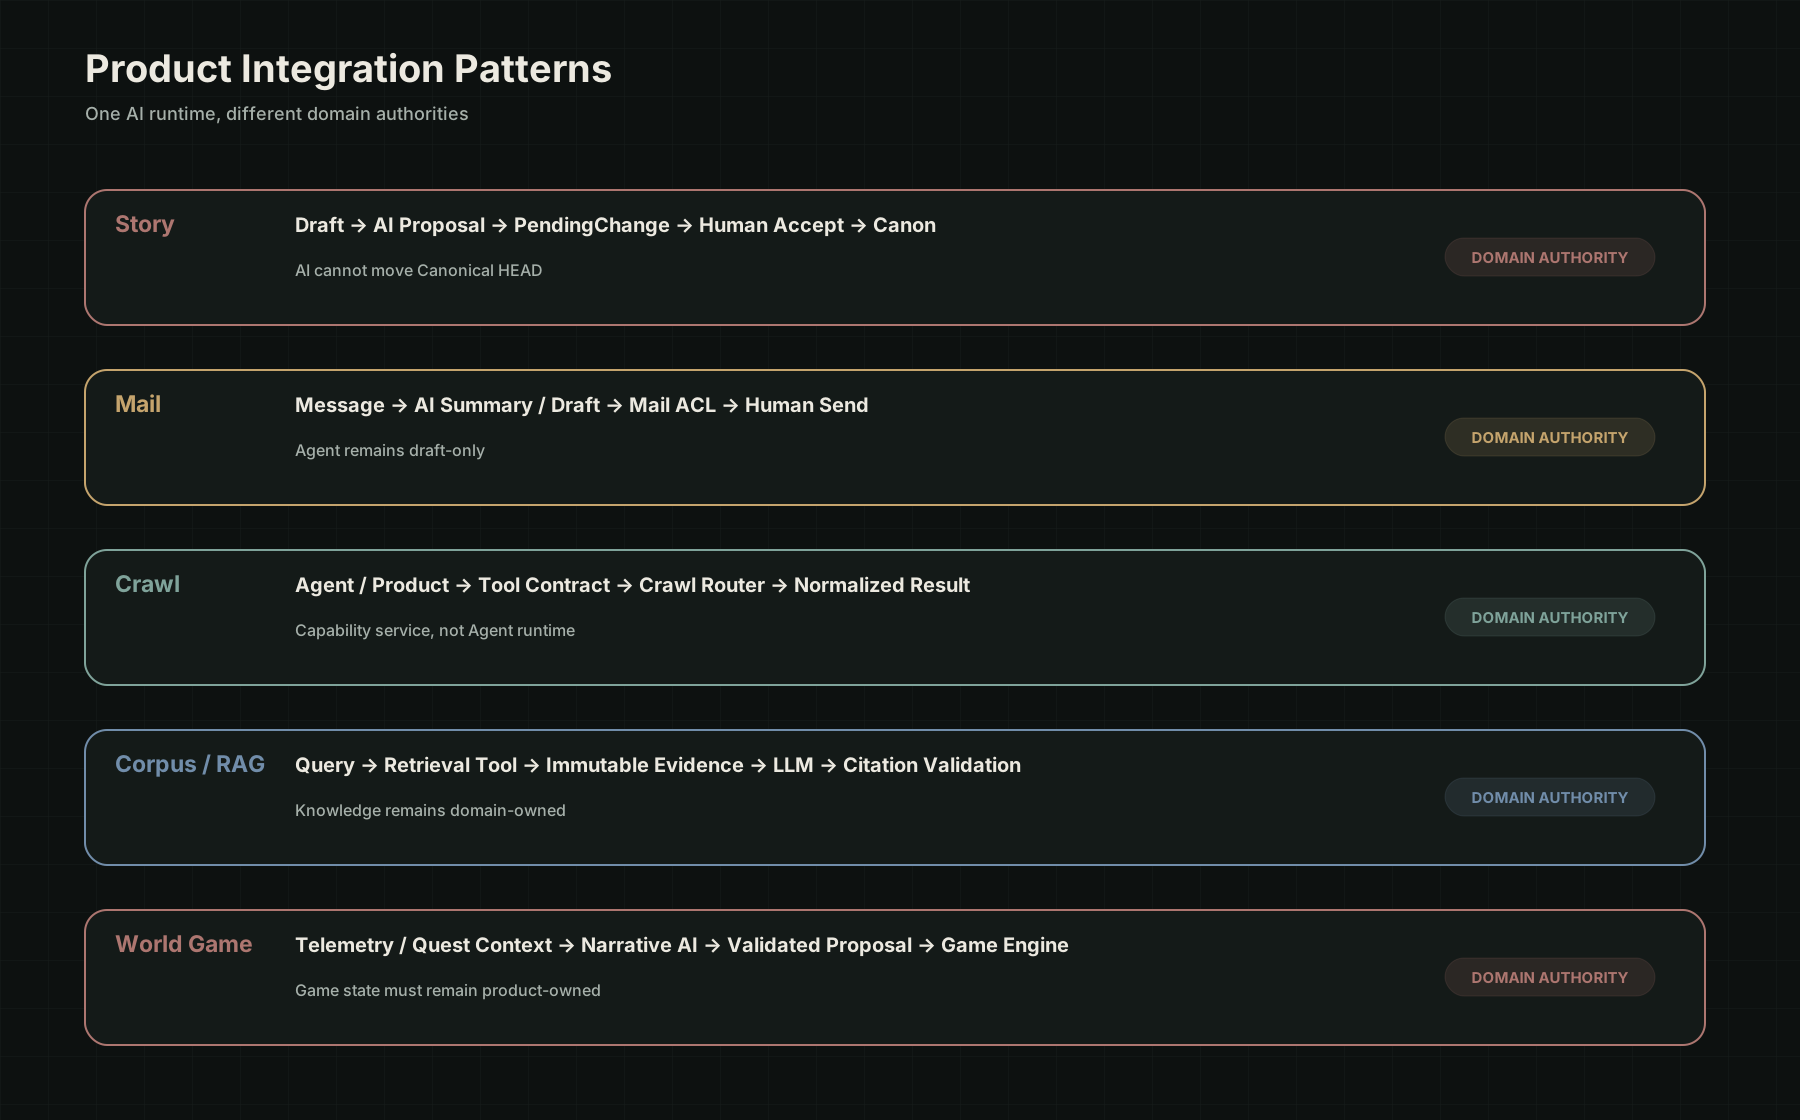
现在最值得关注的不是又接入了多少产品,而是 不同产品开始在复用同一套 AI Runtime 的同时,保留各自最终事实的控制权。
5.1 Story:目前最成熟的参考 Product
Story 的核心状态链可以简化成:
1 | Project |
AI 可以生成场景、审查连续性、研究、提出修改,但输出不能自动移动 Canonical HEAD。
这其实提供了一个非常值得复用的平台模式:
AI 负责 Proposal,Domain 负责 Commit。
以后无论是复杂写作、个人计划、社区治理还是游戏叙事,都可以沿用这个原则。
5.2 Mail:第二个重要的安全样板
Mail V3 把 Browser、Developer REST、MCP、Agent 身份明确拆开。Developer Key 可以在平台层验证,MCP OAuth 可以在 AI Workflow/MCP 平面终止,但 Mail 仍然必须重新按照 mailbox ACL 和 resource policy 做 Domain Authorization。
更关键的是,Mail Agent 现阶段保持 Draft-only,自动发送继续关闭。
它证明了另一个可以长期保留的模式:
1 | Platform Authorization |
5.3 TTS:最早的迁移验证对象
TTS 是 AI Workflow 最早的真实产品集成之一。它的意义不只是“成功调了一次统一 Workflow”,而是帮平台建立了 Compare、双路径、灰度、成本与质量 Gate 的早期经验。
它也说明一个统一 AI 平台不应该用“大爆炸迁移”的方式替换原业务:旧路径可以继续作为 Authority,新路径先做 Compare,再根据质量、延迟、成本和错误率逐步切换。
5.4 Chat / Community
Chat 和 Community 的关键并不是让 Agent 有更多权限,而是保证:
- Product Queue 仍然控制业务事件;
- 同一消息不会因为 Retry 产生多份最终回复;
- AI Workflow 成功而 Product Write 失败时,可以复用已完成结果;
- Community AI 保持 advisory,不绕过业务审核逻辑。
5.5 World Game
World Game 目前仍然更偏产品和运行时建设阶段,但未来如果接入 AI Workflow,最重要的边界不应该改变:AI 可以基于遥测、Quest、NPC 和 Narrative Context 产生建议或新脚本,但 HP、背包、经济、位置、战斗、天气和玩家会话等实时游戏状态仍然属于 Game Runtime。
否则一个叙事 Agent 很容易越界成“游戏服务器”。
六、把所有模块放在一起:现阶段真实依赖关系
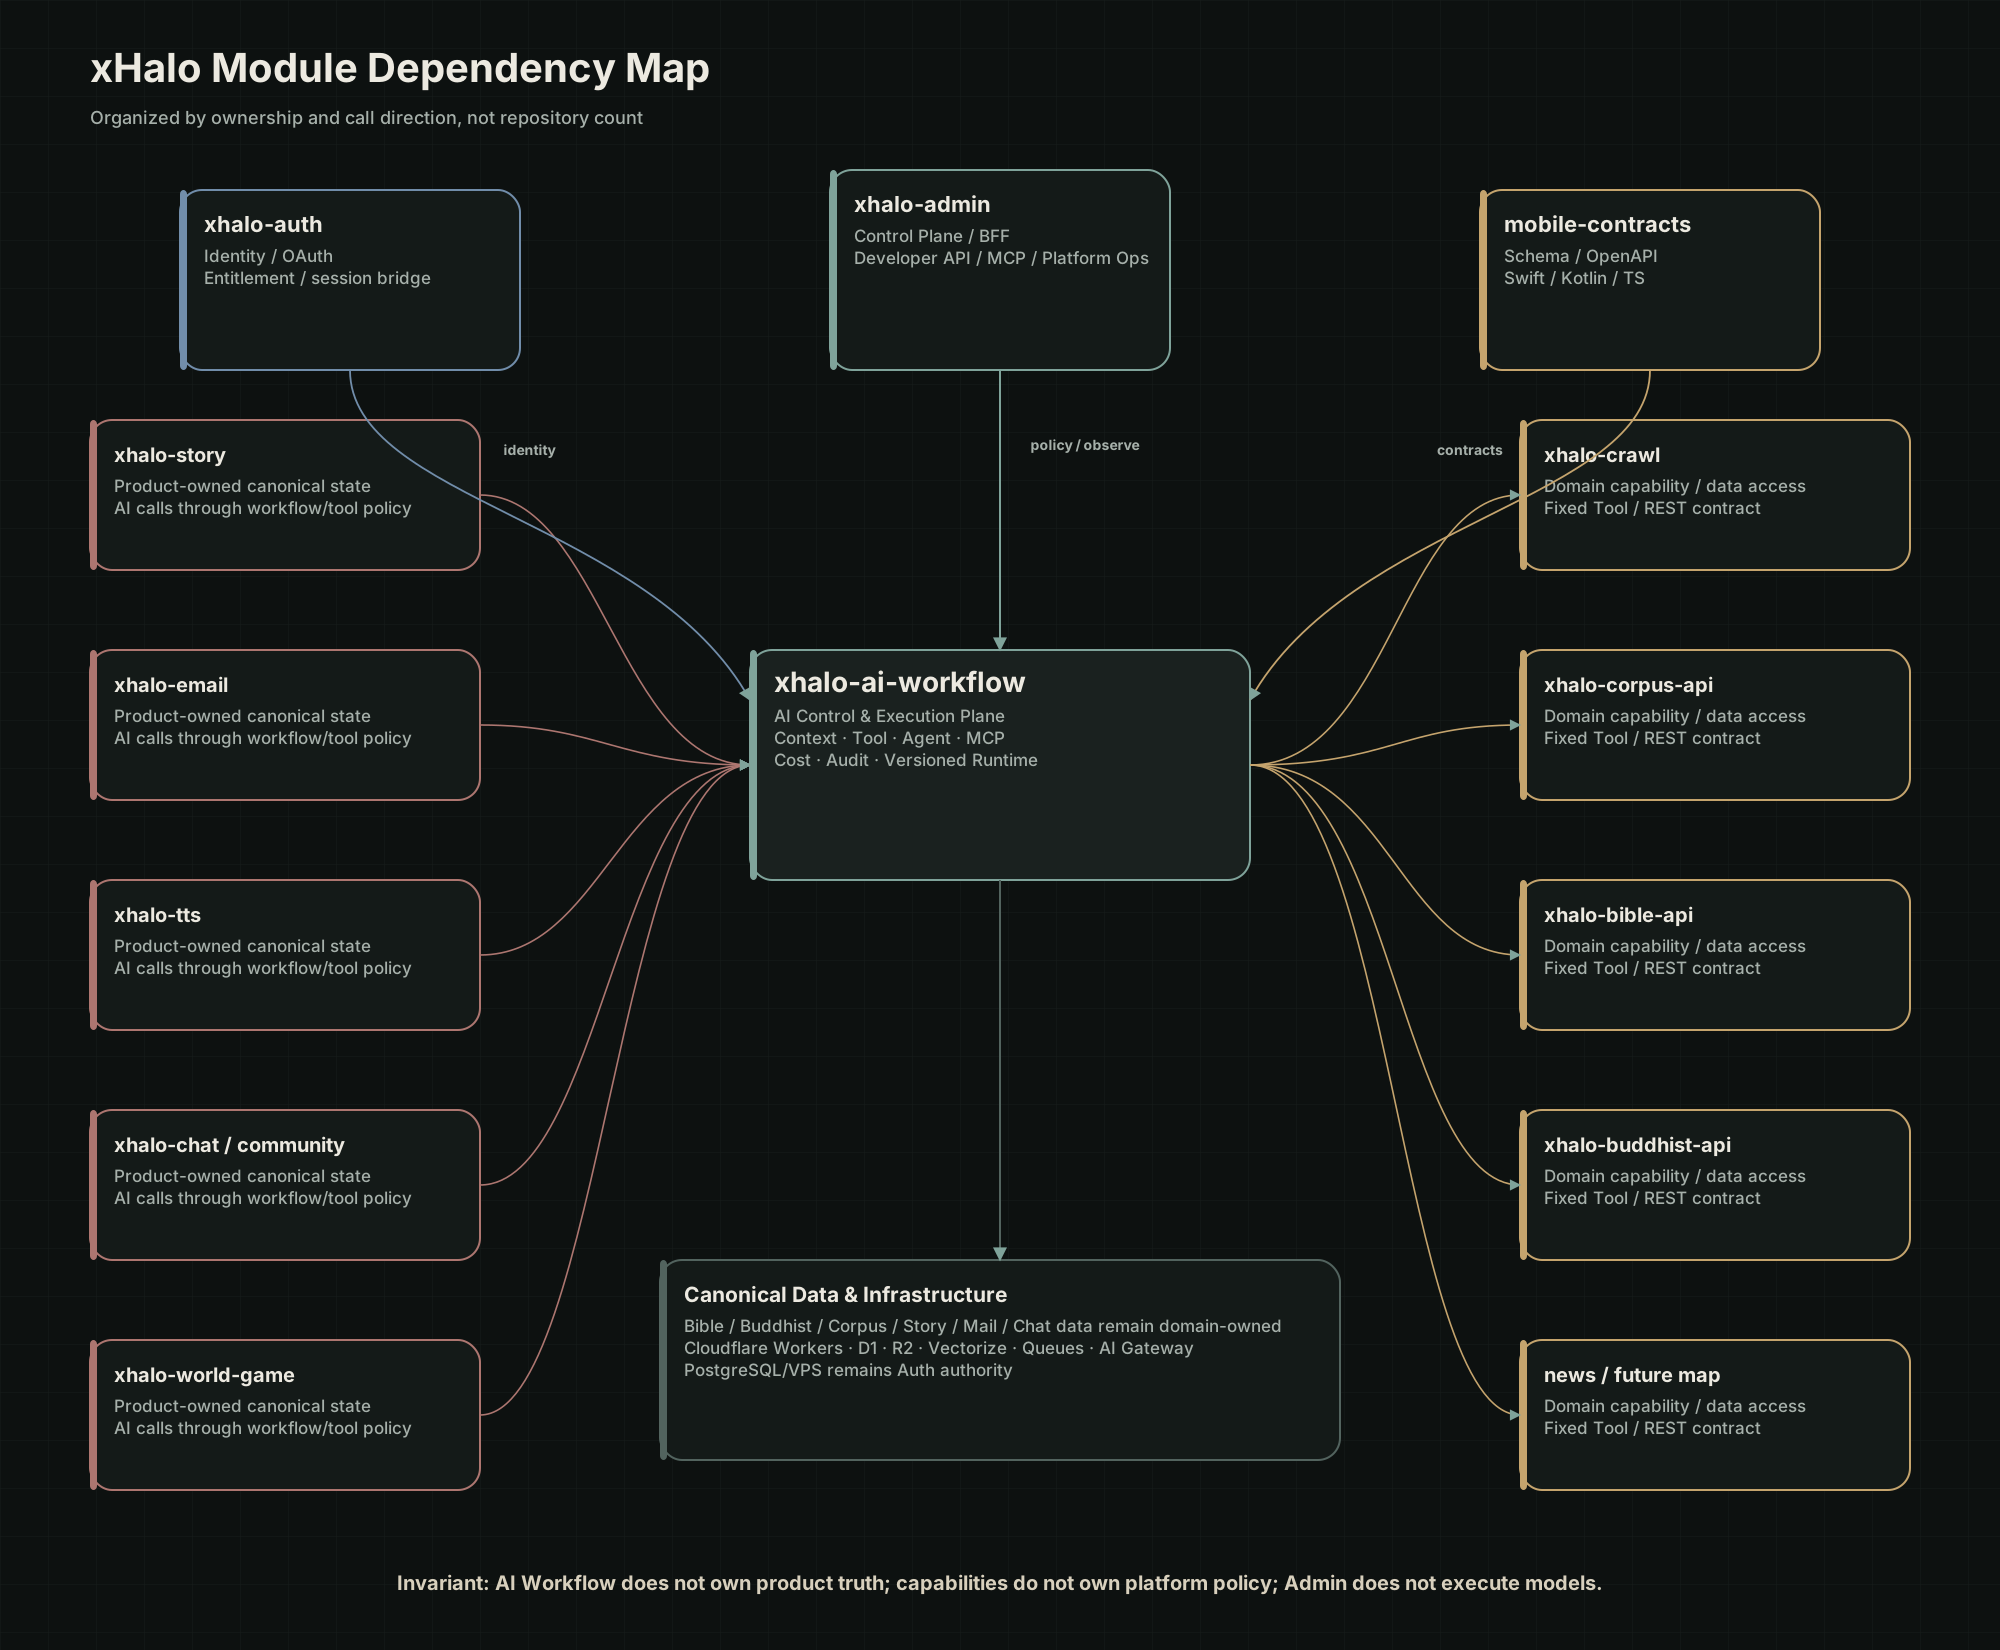
这张关系图可以概括成三条主链。
第一条:身份与控制链
1 | xhalo-auth |
第二条:AI 执行链
1 | Product |
第三条:数据所有权链
1 | Bible → Bible Data |
这里不能反向理解成:“因为 AI Workflow 能调用这些服务,所以这些数据就属于 AI Workflow。”
调用权和所有权必须始终分离。
模块职责表
| 模块 | 当前角色 | 应该拥有 | 不应该拥有 |
|---|---|---|---|
xhalo-auth |
Identity Authority | Identity、Session、OAuth、Entitlement | Mailbox、Story、TTS 等业务状态 |
xhalo-admin |
Platform Control Plane | 配置、观察、审计、发布策略、Developer Policy | 模型执行、最终产品写入 |
xhalo-ai-workflow |
AI Control & Execution Plane | Workflow、Context、Tool、Agent Policy、Cost、Trace、MCP Projection | 所有产品中央数据库、Canonical Domain State |
xhalo-crawl |
Acquisition Capability | Fetch、Render、Search、PDF、Normalize | MCP/OAuth、Agent Runtime、Developer Key 发行 |
xhalo-corpus-api |
Knowledge Domain API | FTS/Semantic/Hybrid、Context、Citation | 通用 AI Workflow 状态 |
| Bible/Buddhist API | Canonical Knowledge API | 经文搜索、检索、Evidence | 平台身份与 Workflow |
xhalo-story |
Product / Narrative Domain | Canon、Draft、Memory、ContextPack、Final Writes | Provider Routing / 平台成本账本 |
xhalo-email |
Product / Mail Domain | Mailbox、Delivery、ACL、Draft / Send | 平台 OAuth/MCP Tool Registry |
| TTS / Chat / Community / Game | Product Domain | 用户体验和业务事实 | 通用 Provider / Tool 平台 |
七、这套架构不是一次设计出来的:分阶段实施过程
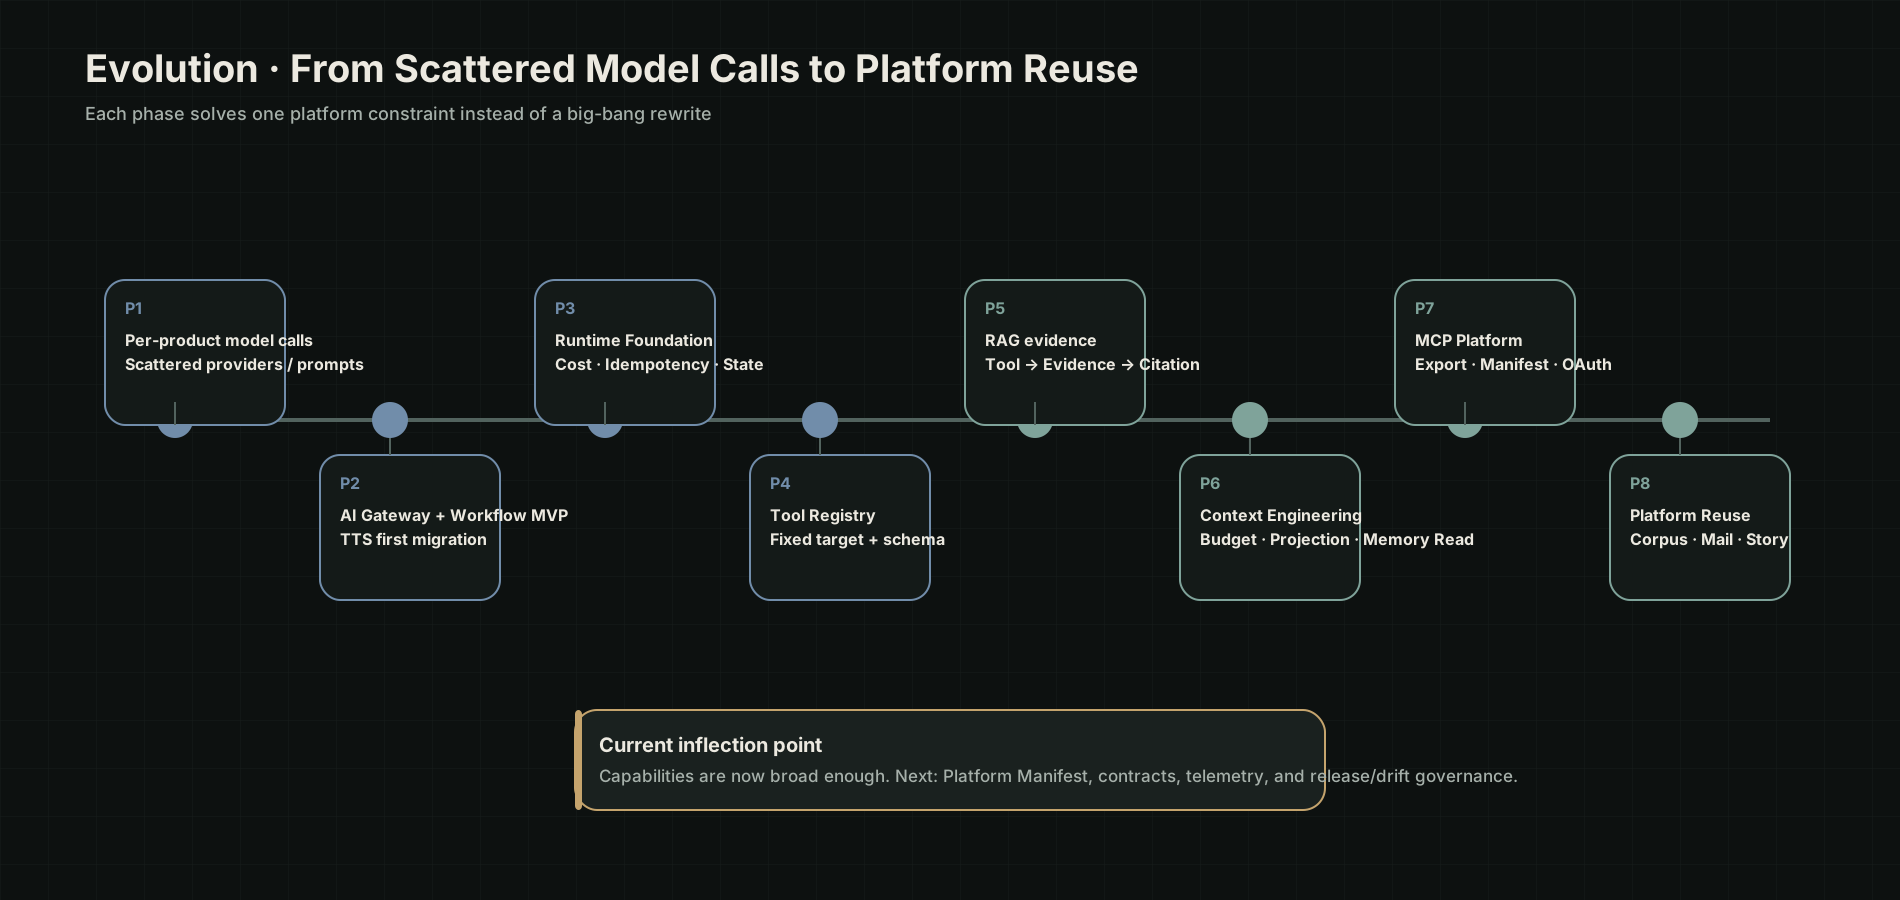
回看整个演进过程,可以看到 xHalo 并不是先画出一张完整架构图再实现,而是在不断遇到真实问题后逐步抽象平台能力。
Phase 1:各业务独立调用模型
最初的模式很简单:
1 | TTS → Model |
但随着产品增加,问题开始重复出现:Provider Key 分散、Prompt 分散、模型替换困难、重试策略不同、成本无法统一、Trace 不完整。
这是 AI Workflow 出现的真正原因。
Phase 2:AI Gateway + Workflow MVP
第一阶段平台化主要统一:
- Gateway;
- Model Alias;
- Prompt;
- Workflow;
- Run;
- Usage;
- Audit。
TTS 成为早期真实迁移对象,证明业务可以把 AI 调用逻辑从项目内部抽离出来。
Phase 3:Runtime Foundation
当调用数量上升后,单纯的“统一接口”已经不够,开始补:
- Cost Reservation / Ledger;
- 幂等;
- Run / Step State Machine;
- Retry Boundary;
- Replay;
- Recovery;
- Queue / Approval Boundary。
这一步让 AI Workflow 从 Wrapper 变成 Runtime。
Phase 4:Tool Registry
有了 Workflow 后,下一步自然是 Tool。但没有直接开放任意 HTTP Tool,而是先定义版本、Owner、Transport、Schema、Timeout、Retry、Size、Side Effect 和 Data Classification。
这一阶段实际上奠定了后面 Agent 和 MCP 的安全边界。
Phase 5:RAG Evidence
Bible/Buddhist 接入后,RAG 开始从“向量搜索 + Prompt”变成:
1 | Tool |
Evidence 被固定、哈希和校验,模型不再拥有对 Canonical Data 的自由解释权。
Phase 6:Context Engineering
7 月底的 Context Engineering 是一次明显转折。
系统开始关注:
- Context Budget;
- Tool Result Projection;
- 大结果 Reference;
- Read-only Memory;
- Deterministic Discovery;
- Bounded Agent;
- Provider Context Adapter。
这一步使平台开始具备真正的 Agent Runtime 前提,而不是简单地把更多历史消息塞进 Prompt。
Phase 7:MCP Platform
Tool Registry 随后被投影成 MCP Export / Immutable Manifest,并接入 OAuth Authorization Code + PKCE、JWT/JWKS、Rate Limit 和 Release Gate。
关键不是“支持 MCP”本身,而是 MCP 没有另造一套 Tool Truth。
Phase 8:Platform Reuse
8 月中下旬开始,Corpus、Mail、Story 逐渐成为真正的平台消费者。
尤其 Story 的 Workflow、Tool、MCP 和 Production allowlist 接入,意味着 AI Workflow 开始跨过一个非常重要的临界点:它不再只是“几个项目共用的工具库”,而成为可以承载不同 Domain 的共享平台能力。
也正是在这个阶段,新的问题开始从“功能缺失”转向“平台治理”。
八、现阶段做得最好的部分
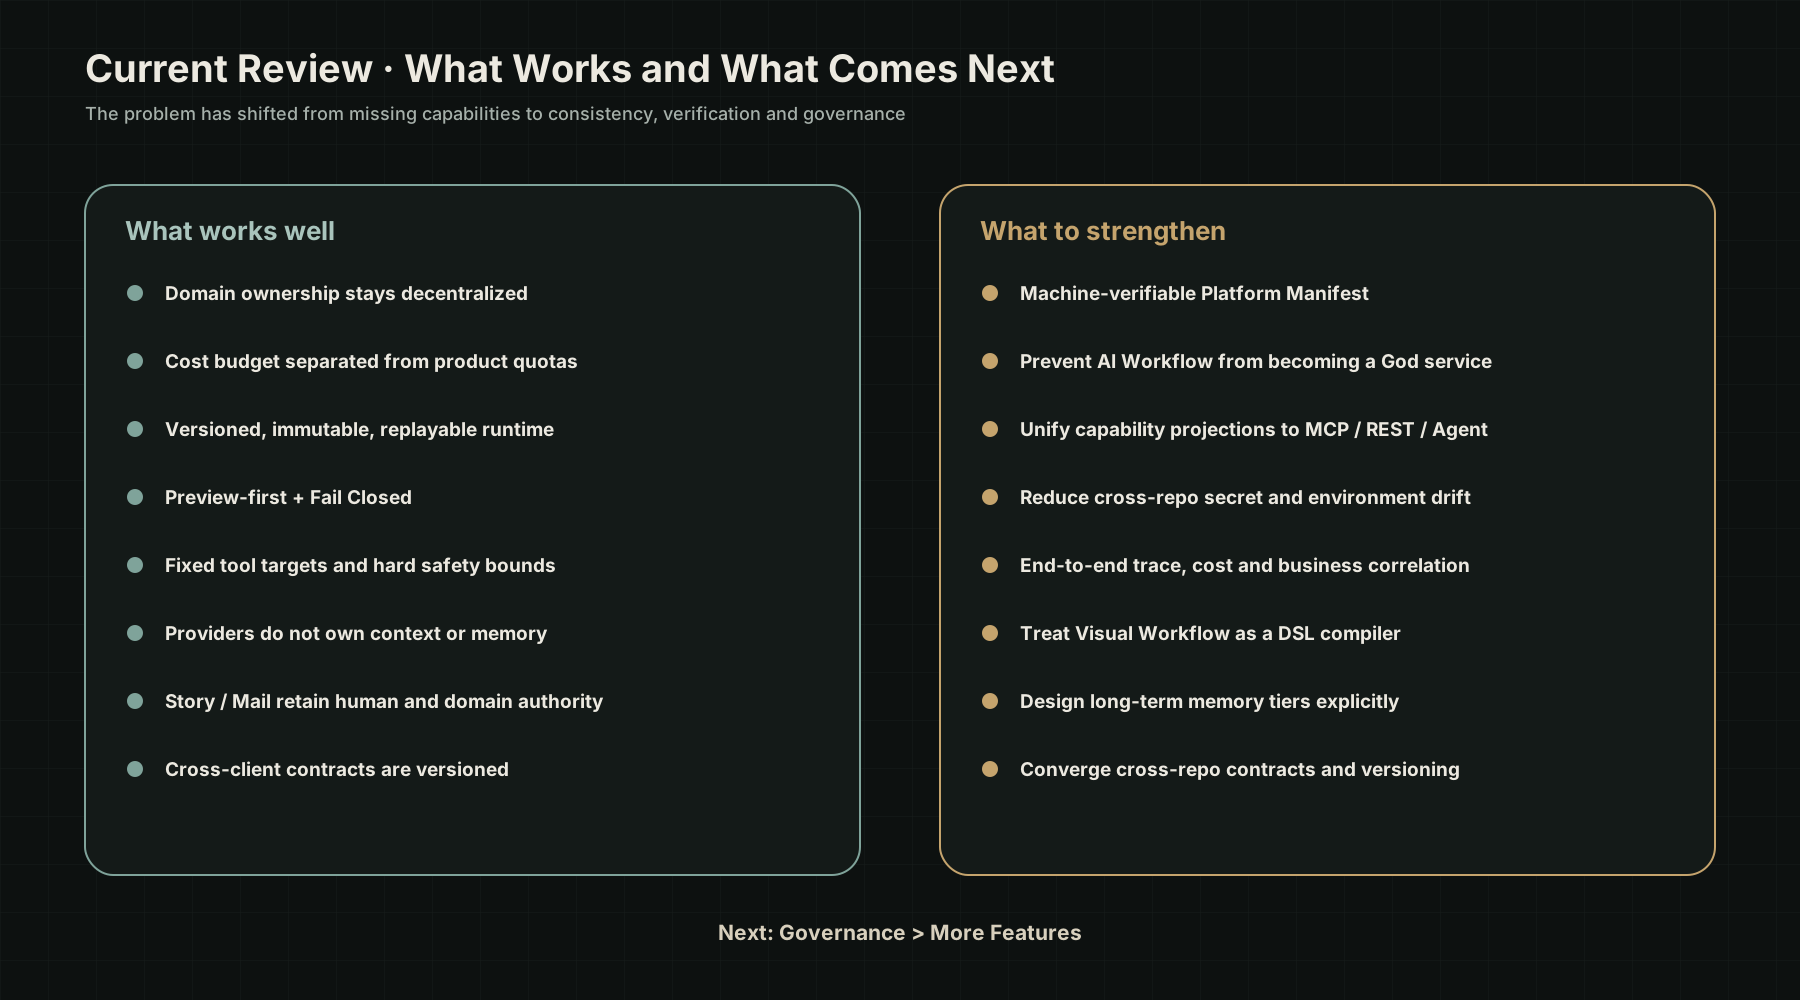
8.1 没有建立中央业务数据库
这是当前最重要的一项正确决策。
如果为了统一 AI,很早就把 Chat、Story、Mail、TTS、Corpus、Bible 等数据都搬进一个平台数据库,今天的依赖关系很可能已经无法拆解。
现在 Product / Domain Ownership 基本还在,是后续继续扩展的前提。
8.2 AI 成本和业务额度被正确拆开
Product 管“用户能不能用、能用多少次”;AI Workflow 管“这次执行对 Provider 产生多少真实成本”。
这使未来可以在不破坏套餐逻辑的情况下切换模型、Route 或 Provider。
8.3 Version / Immutable / Replay 思维成熟得比较早
Workflow、Prompt、Tool、Route、Manifest、Budget 和 Run Snapshot 都越来越倾向于版本化、不可变和可回放。
这比单纯“把配置放数据库里随时修改”更适合 Agent 平台,因为模型行为的可追踪性依赖于执行时到底使用了哪个版本。
8.4 Preview-first + Fail Closed 已经成为工程习惯
Context Engineering、MCP、Tool、Agent 等高风险能力大多先在隔离 Preview 验证,再逐项进入 Production;默认开关倾向于关闭,而不是“部署即启用”。
这种习惯非常值得保留,因为后续 Computer、Browser、Map、长期 Memory 的风险都会更高。
8.5 Tool Security 边界清晰
固定 Target、Schema、Timeout、Retry、Response Limit、Side Effect、Allowlist,比开放通用 HTTP Tool 更保守,但也更适合作为基础设施。
一个平台最难补的往往不是功能,而是早期没有留下安全边界。
8.6 Provider 没有反过来控制 Context
Provider Adapter 只是模型能力适配器,不拥有 Memory、Context、Permission 和 Cost Policy。
这可以避免平台被某一家模型厂商的“原生记忆”“原生 Agent”能力绑死。
8.7 Human / Domain Authority 没有让位给 Agent
Story 的 PendingChange、Mail 的 Draft-only、Community 的 advisory,都体现了同一原则:模型可以建议,但最终有副作用的写入仍然经过 Domain Policy 或 Human Gate。
这会成为未来更复杂 Agent 的安全基础。
8.8 多端 Contract 已经开始独立版本化
Mobile Contracts 现在规模还小,但它解决的是未来最容易产生技术债的问题之一:Web、iOS、Android 不应该分别复制“看起来差不多”的类型。
九、已经开始暴露的结构性问题
现阶段最需要警惕的是:xHalo 已经不缺能力了,但能力之间开始产生治理复杂度。
9.1 最大问题:缺少唯一、机器可验证的 Platform Truth
目前至少同时存在:
1 | GitHub Code Truth |
这些事实源之间已经出现时间差。
例如本轮复盘中可以观察到:相邻仓库中仍有文档保留较早的 Production MCP 范围描述,而 xhalo-ai-workflow 后续已经继续推进 Story Tool/MCP 的 Production activation。这里的问题不是某一篇 README 没更新,而是 发布事实仍然依赖人肉同步多个仓库。
下一阶段应该建立真正的:
1 | xHalo Platform Manifest |
至少包含:
1 | services: |
然后让 Admin、Docs、Drift Check、Release Gate 和 Architecture Inventory 尽量从同一份机器事实生成,而不是各自维护一份列表。
9.2 AI Workflow 已经接近 God Service 的风险区
现在它拥有 Workflow、Context、Model、Cost、Tool、Agent、MCP、Memory Read、Provider Adapter 和 Approval,这些仍然属于“AI 如何执行”的范畴。
但以后如果继续把 Crawl 数据、Map POI、Mail 业务逻辑、Game State、Personal State、Search Index 直接搬进来,就会越界。
以后判断一个功能是否应该进入 AI Workflow,可以只问一个问题:
它是在定义“AI 如何执行”,还是在定义“业务是什么”?
后者应该回到 Domain Service。
9.3 Tool / MCP / Developer API 的权限定义开始重复
一个能力现在可能同时经过:
- Product ACL;
- Tool Registry Policy;
- AI Workflow Production Allowlist;
- MCP Manifest;
- OAuth Scope;
- Developer API Scope;
- Developer Key Policy;
- Admin Policy。
每一层都有存在理由,但如果全部手工同步,平台会越来越脆弱。
下一步更好的方向是:
1 | Capability Definition |
即 One Capability Definition, Multiple Projections。
9.4 Internal Service Identity 还需要统一
现阶段仍然存在不少 shared secret、Service Binding、scoped principal 和 Preview/Production 环境组合。历史上已经出现过 secret 不一致、绑定指向错误环境、文档假设与真实调用路径不一致等问题。
长期应该逐渐把“很多独立 XXX_INTERNAL_SHARED_SECRET”收敛为更明确的:
1 | Service Binding Identity |
静态 secret 可以继续存在,但不应该成为所有内部服务通信的最终模型。
9.5 Observability 仍然缺少真正的端到端 Trace
现在每个项目都有一些指标:AI Workflow 有 Run/Cost,Crawl 有 Usage,Mail 有 Audit,Story 有 Analytics,Auth 有 Session/Audit。
但还缺一个完整链路:
1 | User Action |
建议统一至少这些字段:
1 | trace_id |
这对以后移动端遥测、Agent Debug、成本归因和事故排查都会非常重要。
9.6 Visual Workflow 应该明确为“编译器前端”
计划中的拖拽式 Workflow 管理是正确方向,但它不应该演变成“浏览器直接操纵 Runtime”。
更稳妥的流程是:
1 | Visual Editor |
也就是说,Visual Workflow 应该是 Workflow Compiler Frontend,而不是一个绕开版本与发布流程的实时流程图。
9.7 Memory 目前仍然有意保守,但以后必须重新分层
现阶段 Memory Read 保守、Memory Write 和 model-managed memory 没有被轻易放开,这是正确的。
但未来真正的长期移动端 Agent 会需要区分:
- User Memory;
- Product Memory;
- Session Memory;
- Canonical Domain Memory;
- Agent Working Memory。
最危险的做法,是未来直接建立一个“全局用户记忆表”让所有 Agent 自由读写。
9.8 Cross-repo Contract 还需要继续收敛
Mobile Contracts 已经证明独立契约仓库是可行的。下一阶段可以考虑进一步形成平台级 xhalo-contracts 逻辑边界,管理:
- Platform Error Envelope;
- Auth / Principal;
- AI Run;
- Tool Contract;
- Event Envelope;
- Telemetry;
- Mobile Compatibility。
它应该只是 Contract / Schema / Generated Client 平面,不应该再次变成 Runtime monorepo。
十、下一阶段不应该优先“再增加更多能力”
如果只看产品路线,接下来仍然有 Map、Computer、图片工具、更多 Corpus、World Game、Mobile Agent 等大量能力可做。
但从现阶段架构成熟度看,下一阶段更重要的事情其实是 平台治理闭环。
Priority 1:Platform Manifest / Live Inventory
目标:回答任何时候的一个问题——
Production 到底有哪些 Service、Binding、Tool、Scope、Flag、Domain 和版本正在生效?
并让这个答案机器可生成、可比较、可审计。
Priority 2:Capability Catalog
把 Tool、MCP、Developer REST、Agent Permission、Admin Surface 和 Docs 从“多份配置”收敛为同一个 Capability Source 的不同投影。
Priority 3:Cross-repo Contracts
让 Web、Worker、iOS、Android、MCP 和 Developer API 对相同概念使用稳定版本的契约,而不是依赖仓库之间复制类型。
Priority 4:Unified Telemetry / Trace
建立 Product → AI → Tool → Model → Domain Write 的统一追踪和成本归因。
Priority 5:Release & Drift Governance
把现在已经形成的 Preview-first、Fail Closed、Rollback、Immutable Version 进一步扩展到跨仓库发布:
1 | Source Change |
只有这套闭环建立后,xHalo 再增加 Map、Computer 或更多 Agent 能力时,复杂度才不会重新变成项目之间的隐式依赖。
十一、现阶段架构成熟度判断
如果不以“功能多少”评分,而以平台是否具备长期演进能力来判断,我会给出大致这样的状态:
| 领域 | 现阶段判断 |
|---|---|
| Domain Ownership | 已形成较清晰边界 |
| AI Workflow Runtime | 已进入平台内核阶段 |
| Tool Architecture | 安全约束和版本化较成熟 |
| Context Engineering | 已具备 Agent Runtime 的基础 |
| Cost / Audit | 已从产品逻辑中独立出来 |
| MCP Platform | 已从实验能力进入真实平台复用 |
| Auth / Identity | 基础稳定,但内部身份仍需继续统一 |
| Developer Platform | 已形成雏形,Capability 投影仍需收敛 |
| Cross-repo Contracts | 已起步,尚未成为全平台标准 |
| Platform Observability | 各模块有能力,端到端关联不足 |
| Deployment Truth / Drift Control | 是当前最需要优先加强的领域 |
| Long-term Agent Memory | 仍处于应保持谨慎的早期阶段 |
这也说明 xHalo 当前已经进入一个不同于前期的阶段:
过去的问题是“有没有这项能力”;现在的问题开始变成“这些能力是否仍然属于一个一致、可验证、可治理的平台”。
十二、最后总结:保持三个所有权边界
如果把整篇复盘压缩成一个最值得长期保留的架构原则,我会写成下面三句话:
AI Workflow 决定 AI 怎样思考和调用能力。
Capability Service 决定能力怎样执行。
Product / Domain 决定什么最终成为现实状态。
只要这三个边界不被打破,xHalo 就可以继续增加新的模型、Tool、MCP、Corpus、Map、Computer、Mobile Client 和 Game,而不需要把所有东西重新合并成一个巨型系统。
相反,如果未来为了开发方便让 AI Workflow 直接拥有业务数据、让 Capability Service 自己发行平台权限、让 Admin 直接承担 Runtime,或者让 Agent 绕过 Domain 写入,那么今天已经建立起来的平台优势会很快消失。
所以现阶段最值得做的,不是继续证明 xHalo “还能增加多少功能”,而是把已经出现的平台结构固定下来:统一事实源、统一 Capability Catalog、统一 Contracts、统一 Telemetry,并让 Preview / Production / Rollback / Drift 成为同一个发布治理体系。
到了这一步,xHalo 才真正从“多个项目共同使用一套 AI 服务”,走向“一个能够持续扩展的新型 AI 应用基础设施”。