从网页抓取到可引用知识:xHalo Crawl 与 Corpus 项目架构复盘
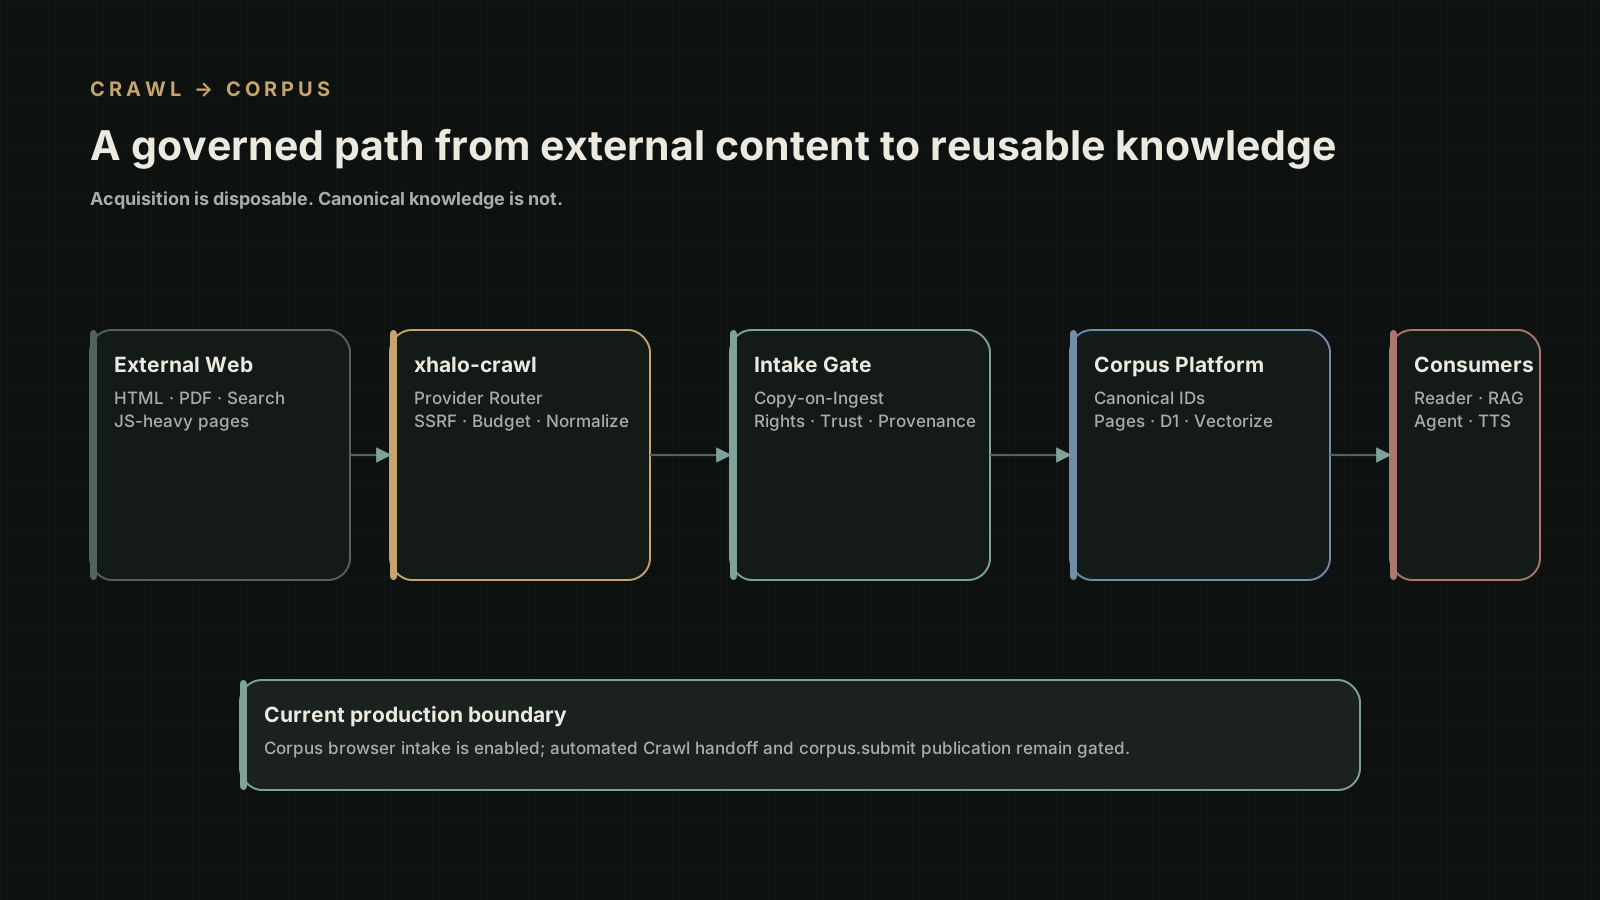
如果只看功能列表,xhalo-crawl 和 xHalo Corpus 很容易被理解成两个相邻但不同的项目:前者负责抓网页、搜索、浏览器渲染和 PDF,后者负责诗歌数据、语义搜索和 RAG。
但复盘到现阶段,它们更适合被理解成同一条数据生命线的前后两段:
Crawl 负责把“不可信、会变化、来源复杂的外部内容”变成受约束的采集结果;Corpus 负责把“值得长期保留的内容”变成有稳定身份、Rights、Provenance、Release 与 Citation 的可复用知识。
这两者之间的区别非常重要。
网页抓取结果可以过期,可以重新抓取,可以因为 Provider、时间、动态渲染而变化;Canonical Corpus 则不能随着某个 URL 今天返回什么内容就一起漂移。正因为如此,xHalo 没有把 Crawl 做成“直接往向量库里塞网页”的管线,也没有把 Corpus 做成“一个更大的爬虫数据库”。中间增加了 Copy-on-Ingest、Rights、Trust、Stable ID、Provenance、QA 和 Immutable Release 等治理层。
截至 2026 年 8 月下旬,这条架构已经完成了大部分关键地基:Crawl 的主要 REST、Search、PDF、Browser Run、OCR 与 Studio 已进入生产;Corpus 的 Poetry 生产读平面已启用,活动 Release 包含 349,506 个作品,Public API 与 Semantic Search 已开放,管理员认证的 Browser Intake 也已启用。
但最值得注意的是:自动 Crawl → Corpus handoff、corpus.submit Production allowlist 和自动 Publication 仍然保持关闭。
这不是“还差一个开关”,而是整个项目目前最重要的一条边界。
一、为什么需要把 Crawl 与 Corpus 放在一起复盘
xHalo 的知识能力最初并不是从一个完整“Corpus Platform”设计开始的。
更早的时候,数据问题主要以独立领域存在:Bible 有 Bible Data 和 RAG,Buddhist 有自己的数据加工与向量化,News 有采集和归档,Blog 有 Markdown 内容,Crawl 则解决“怎样从网页拿到可用内容”。随着 Poetry、文学、剧本、心理学等后续知识域进入规划,一个重复的问题越来越明显:
- 每个数据域都重新写 Source Adapter;
- 每个项目都自己处理 ID、去重、Rights、Provenance;
- RAG Chunk 规则各自发展;
- Embedding、Vectorize 导入与缓存重复建设;
- 原始数据、规范化数据、发布数据之间没有统一边界;
- Crawl 抓到的网页内容无法安全地直接变成长期知识资产。
于是 Corpus 的意义逐渐清楚:它不是“另一个内容 API”,而是 xHalo 的 Canonical Corpus Compiler + Knowledge Release Plane。
同一时期,Crawl 也从简单的 fetch 服务逐步发展成统一采集能力:不仅有 Direct Fetch,还加入 Browser Run、Search、PDF、OCR、Provider Router、预算、熔断、SSRF、安全限制和 Studio。
这样,两个项目自然形成了一条链:
1 | External Source |
但现阶段真正成熟的地方,恰恰在于没有把这条链变成“抓完自动发布”。
二、现阶段生产状态:两个项目已经走到不同成熟阶段
在讨论架构前,需要先区分“设计目标”和“真实已上线状态”。
xhalo-crawl 当前生产状态
截至 2026-08-15 的机器状态与 Final Closure 记录,Crawl 的主要能力可以简化为:
| 能力 | 当前状态 |
|---|---|
/v1/fetch |
Production verified |
/v1/render |
Production verified |
/v1/extract |
Disabled |
/v1/crawl |
Production deployed |
/v1/search |
Production deployed |
/v1/pdf/inspect |
Production verified |
/v1/pdf/parse |
Production deployed |
| Jobs / Usage | Production deployed |
| Crawl Studio | Production verified |
| Direct Fetch | Enabled |
| Browser Run | Enabled |
| Serper / Brave / SearXNG / xHalo RAG Search | Enabled |
| Local OCR | Enabled |
| Stagehand | Disabled |
| Crawl4AI | Disabled |
| Scrapling | Disabled |
crawl.* MCP |
Production candidate,未进入 Production Active Manifest |
这里最容易产生误判的一点是:Production deployed 不等于 Production verified。
Search、Jobs/Usage、某些异步和复杂路径虽然已经部署,但仍缺少完整的 authenticated real-data Production round trip。原因不是服务没有上线,而是生产 Developer API Key 的创建路径本身要求真实用户会话,之前的自动化审查没有通过“临时绕过认证”的方式制造测试入口。
因此 Crawl 当前已经是一个真实生产服务,但仍处在“能力已上线、生产证据继续补全”的工程阶段。
Corpus 当前生产状态
Corpus 的状态则更集中:
- Production Corpus API:
corpus.xhalo.co; - Public API:开启;
- Semantic Search:开启;
- Corpus Write:关闭;
- Production D1:
xhalo-corpus-poetry-index; - Production Vectorize:
xhalo-corpus-poetry-bgem3; - Poetry Data:
poetrydb.xhalo.co; - Reader:
poetry.xhalo.co; - 活动 Release:
poetry-2026-08-12-r2; - Work Count:349,506;
- Embedding:BGE-M3,1024 维;
- Browser Intake:Production enabled;
- Crawl Intake:关闭;
corpus.submitProduction Allowlist:关闭;- Publication:关闭。
也就是说 Corpus 已经同时具备两种状态:
- 读平面已经是真实生产系统;
- 写入与发布平面仍然保持严格 Gate。
这种“读成熟、写保守”的状态,我认为是目前非常合理的阶段选择。
三、总体架构:Acquisition Plane 与 Canonical Knowledge Plane
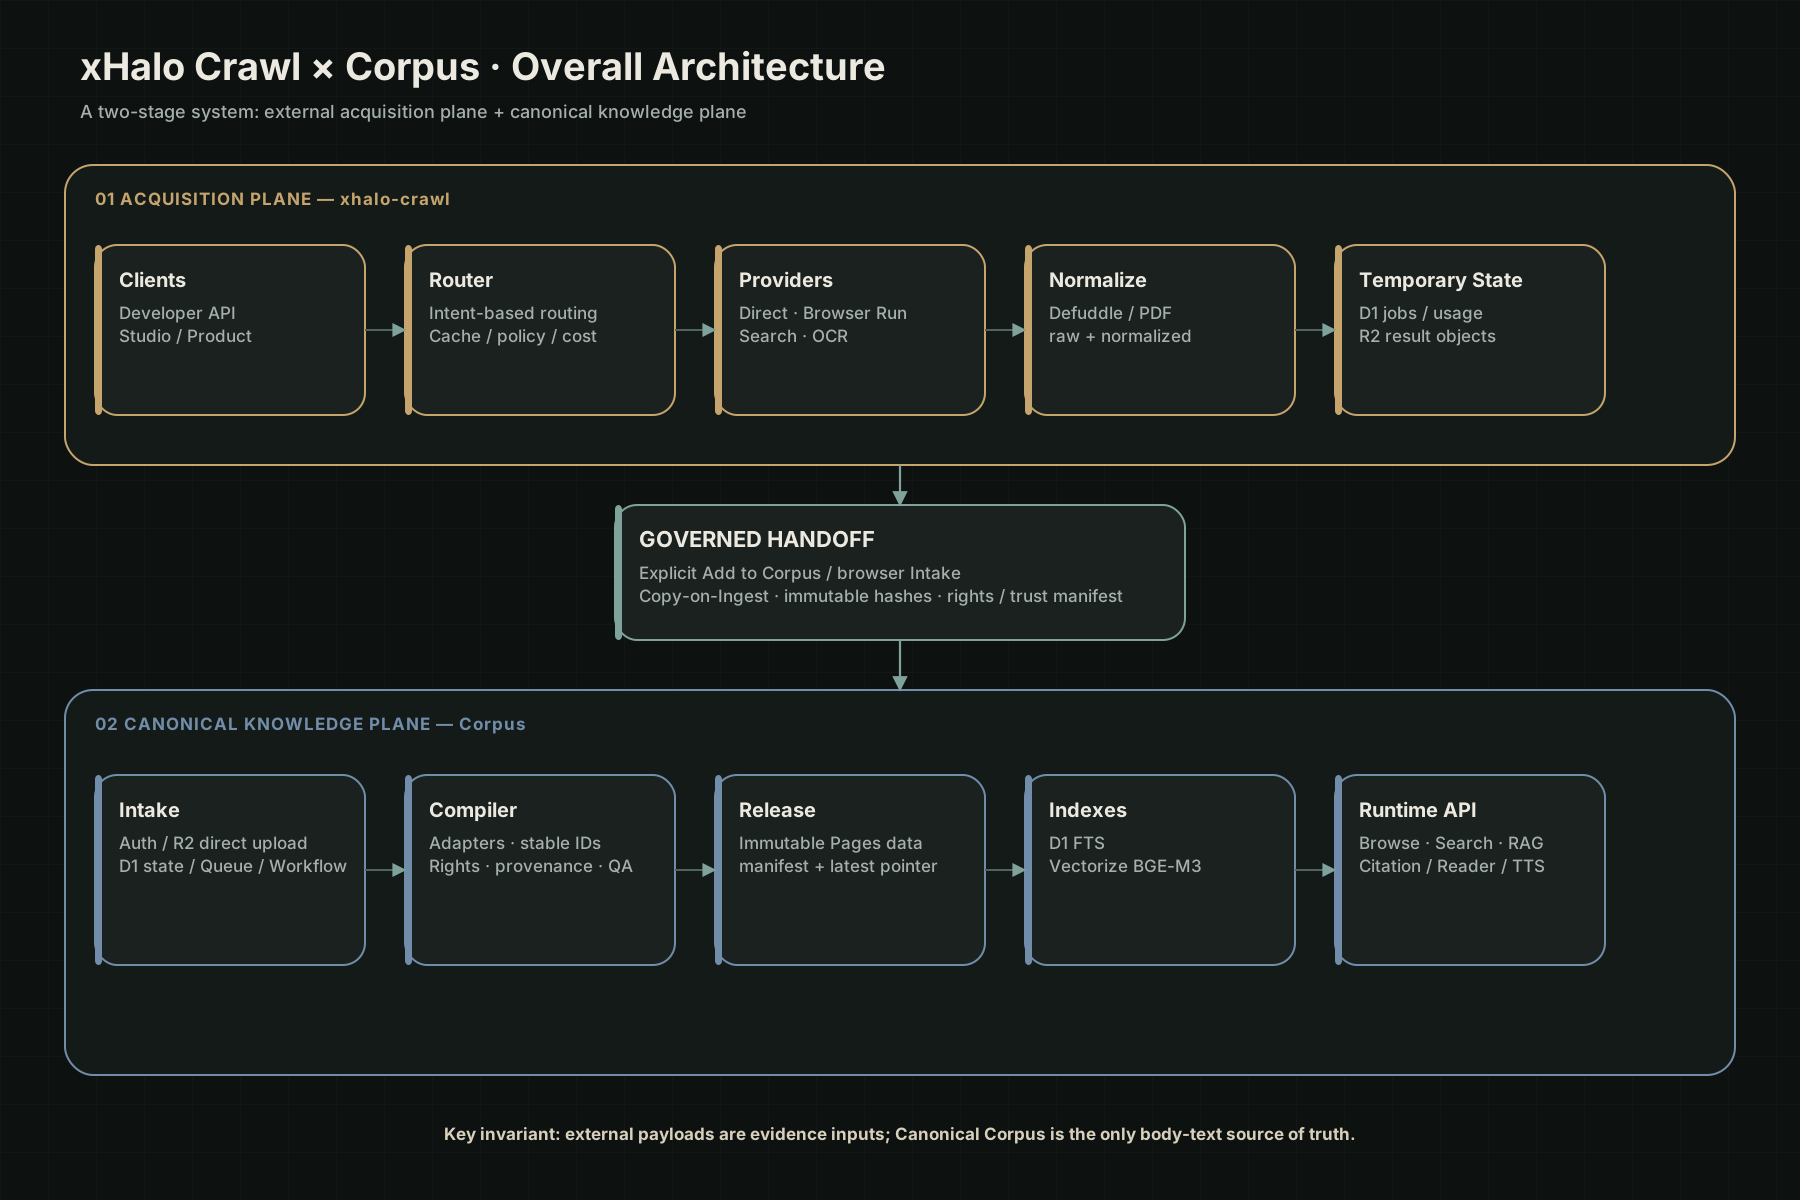
如果只保留最重要的边界,Crawl 与 Corpus 可以被拆成两个平面。
3.1 Acquisition Plane:Crawl 的任务是获得“可处理的外部证据”
Crawl 面对的是互联网本身的不确定性:
- HTML 随时变化;
- JS 页面需要浏览器;
- 搜索结果来自多个 Provider;
- PDF 可能是文本、扫描件、加密文件或恶意结构;
- URL 可能跳转到内网、Metadata Endpoint 或危险目标;
- Provider 的价格、限额和延迟并不相同;
- 抓回来的网页内容本身也可能包含 Prompt Injection。
因此 Crawl 的正确输出不是“知识”,而是:
1 | Acquisition Result |
这些对象是 可审计的采集结果,但并不是长期 Canonical Truth。
3.2 Canonical Knowledge Plane:Corpus 的任务是决定“什么能够成为知识资产”
Corpus 面对的问题完全不同:
- 同一个作品来自多个来源时,它们是不是同一个 Work?
- 原作是公版,但现代译本或注释是否可以发布?
- 一个作品的稳定 ID 应该如何保持不漂移?
- 内容修订后,ID、hash 与 Citation 分别怎么变化?
- 哪些数据是 Canonical,哪些只是检索投影?
- Embedding 是否可以重建?
- FTS、Vectorize 与静态正文之间谁是事实源?
- 发布新数据后如何原子切换?
- 如何回滚到旧 Release 而不破坏引用?
所以 Corpus 的输出不是“抓取结果”,而是:
1 | Canonical Corpus |
这就是两个项目的本质区别。
四、xhalo-crawl:已经从 Fetch Worker 发展为 Acquisition Runtime
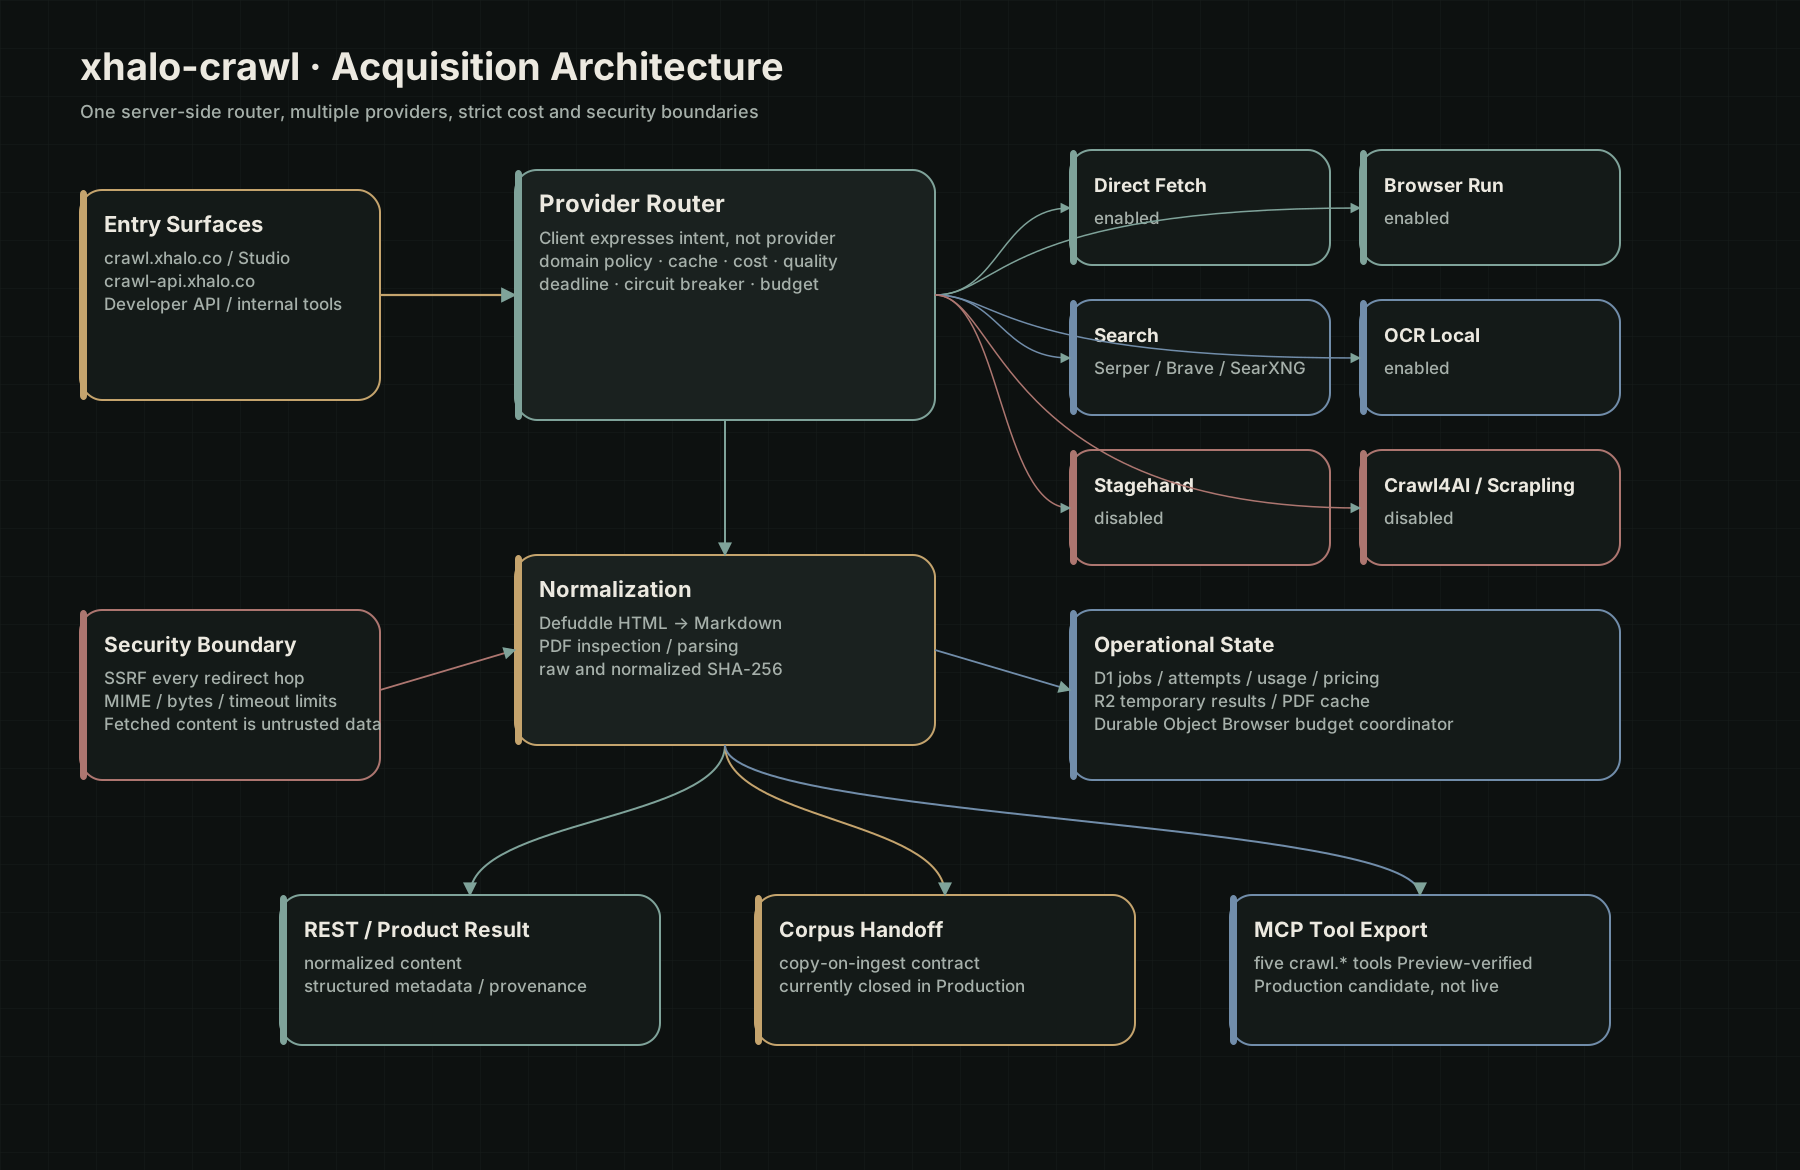
4.1 Provider Router 是 Crawl 的核心,而不是 Provider 数量
Crawl 早期最直观的能力是“抓一个 URL”。但当 Browser Run、Stagehand、Crawl4AI、Scrapling、Search、PDF、OCR 都出现之后,真正需要解决的问题变成:谁来决定该使用什么方式获取内容?
当前设计选择让 Server-side Provider Router 做决定,而客户端只表达 Intent,例如:
- 是否允许浏览器;
- 是否允许异步;
- 最大页面数;
- 最大深度;
- 成本上限;
- 是否需要结构化结果;
- 风险容忍度。
Router 再综合:
- Domain Policy;
- Cache;
- Provider 成功率;
- P95 延迟;
- Cost;
- Circuit Breaker;
- 页面是否 JS-heavy;
- Caller Scope;
- Remaining Budget;
- Approval State。
这是一个很重要的架构选择,因为它避免了客户端逐渐绑定具体 Provider。
如果未来 Browser Run 换成新的实现、Search Provider 调价、某个 Provider 故障,业务端不需要理解这些细节。
4.2 Crawl 的安全层比“抓取功能”更重要
从 Final Closure 的代码和测试看,Crawl 已经形成了一组比较扎实的采集安全约束:
- localhost / RFC1918 / link-local / IPv6 private / metadata endpoint 禁止访问;
- 每一次 redirect 都重新解析 DNS 并重新执行 SSRF Guard;
- 禁止非 HTTP(S) scheme 和非允许端口;
- 限制 raw bytes、decompressed bytes、redirects、pages、depth、execution time 和 result size;
- fetched content 一律标记为 untrusted data;
- 网页正文不能修改 Tool Permission、Budget、Scope 或触发额外未授权操作;
- Interactive / write actions 默认关闭;
- Scrapling 被定义成 approval-gated fallback,而不是绕过 CAPTCHA/WAF/paywall 的工具。
更值得肯定的是,Final Closure 没有只停留在“源代码看起来安全”,而是真正补了 adversarial PDF binary、SSRF redirect、浏览器 CORS 和 /ready binding 验证。
4.3 Browser 和 Search 的成本控制已经从估算走向运行时约束
Browser Run 并不是直接调用后再统计,而是由 CRAWL_BUDGET_COORDINATOR 在执行前进行 reservation,再根据真实使用量 settlement。
Search 也经历了一次比较典型的修正:早期存在硬编码价格和未真正调用的 seed 路径,后来改成 Admin 管理的 versioned pricing ledger,并加入 Provider deadline、rolling failure rate / P95 与 circuit breaker。
这说明 Crawl 的成本模型正在从“开发时知道大概多少钱”转向“Runtime 本身知道这次请求是否应该执行”。
4.4 PDF / OCR 的工程价值高于表面功能
PDF 是 Crawl 中最容易被低估的一部分。
现实 PDF 可能包含:
- CJK / RTL;
- 表格;
- 大图;
- image-only scan;
- malformed xref;
- object explosion;
- embedded JavaScript;
- embedded file;
- encryption;
- compression bomb;
- huge declared image dimensions。
Final Closure 之后,项目已经把这些真实二进制 fixture 固化到 CI,而不是只用几个正常 PDF 做 demo。
同时,Oracle ARM 上的 OCR 也加入了实际并发限制:因为 OCR Worker 与生产 Auth / PostgreSQL 共用 VPS,项目选择使用 Semaphore(1) 把第二个并发 OCR 直接以 503 拒绝,而不是让多个 Tesseract / Ghostscript 进程同时压满主机。
这个取舍并不“漂亮”,但很符合现阶段资源现实。
五、xHalo Corpus:核心不是向量库,而是 Canonical Compiler
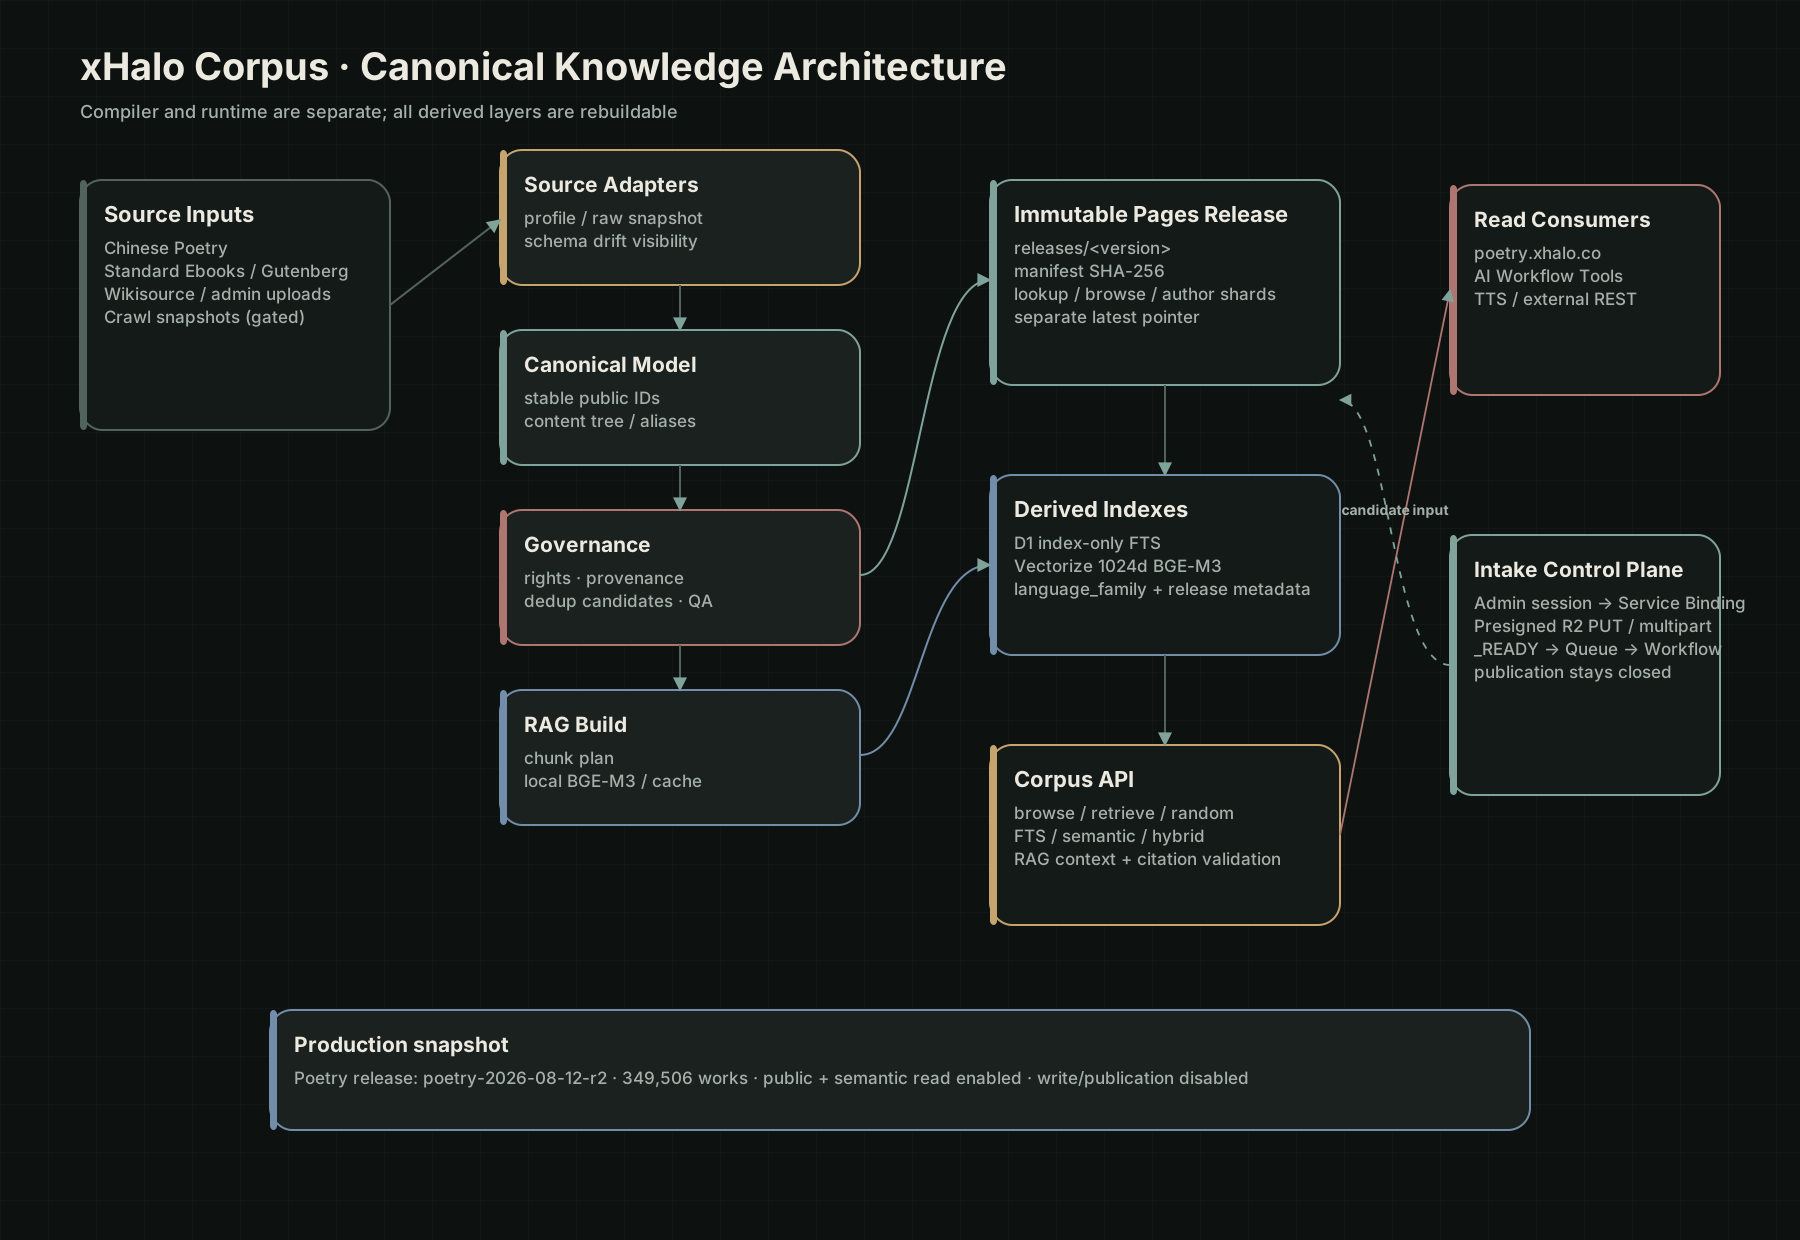
Corpus 项目里最值得保留的设计,是从一开始就没有把 Vectorize 当作知识库本身。
5.1 Canonical Corpus 才是正文事实源
Corpus Pipeline 明确规定:
Canonical Corpus is the only body-text source of truth.
这条原则会直接影响后续所有存储层:
- Pages Release 保存可发布的正文 read model;
- D1 负责索引、FTS 和轻量元数据;
- Vectorize 保存 Embedding;
- R2 保存 Intake 原始对象;
- Embedding Cache 只是构建加速;
- Reader 与 RAG 最终都要回到 Release 中 hydrate 正文。
因此,D1 或 Vectorize 损坏时,理论上应该能够从 Canonical Release 重建,而不是反过来从向量索引“恢复知识”。
5.2 Stable ID 与 Content Hash 被刻意区分
这也是一个容易做错的地方。
如果直接用内容 hash 作为公开 ID,那么文本每次修订都会创建一个新的“作品”;如果只用标题和作者,又会遇到同名、异体、不同 Edition、不同翻译等问题。
Corpus 选择保留:
- stable public ID;
- aliases;
- Work / Edition / structural scope;
- content hash;
- source locator;
- provenance event。
内容发生变化时可以更新 hash,但公共身份并不必然变化。
这为后续 Citation、Reader URL、跨版本兼容和用户收藏提供了稳定基础。
5.3 去重不等于自动合并
Poetry Processing 同时生成:
- exact-content duplicate;
- bibliographic same-work candidate。
但不同来源的 Work / Edition 自动 merge 数保持为 0。
这一点看似保守,实际上是 Corpus 可信度的关键。标题相同、作者相同、正文相近,都不足以让机器直接宣布“这是同一个作品版本”。
系统负责发现候选,人或后续更严格的治理规则负责确认关系。
5.4 Rights 是构建流程的一部分,不是发布前的说明文字
Corpus 把 Rights 拆成多个组件:
- original work;
- edition;
- source terms;
- translation / annotation 等可能存在的派生权利。
未知或 quarantine 的内容不能进入正式 Release。
PoetryDB 的 3,162 条记录就是一个很好的例子:代码能够获取和规范化数据,并不代表数据内容的授权已经明确,因此这些记录被留在 Rights Quarantine,而不是因为“数据已经抓到了”就一起发布。
这会增加运营成本,但比事后清理已经发布的数据可靠得多。
六、Pages + D1 + Vectorize:为什么要采用三层读平面
Corpus 当前生产架构并不是“所有内容塞进 D1”。
后来的一次优化把 Corpus API 改成 index-only D1 + Pages hydration:
1 | Query |
这套结构的优点很明显。
Pages Data
适合:
- 大量不可变正文;
- 静态分片;
- CDN 缓存;
- Release 版本化;
- 文件 hash 校验;
- 低运行成本。
D1
只保留:
- Work index;
- FTS5;
- metadata;
- Citation JSON;
- release/version linkage。
D1 不再承担全部正文,因此数据库更轻。
Vectorize
负责:
- BGE-M3 1024 维向量;
- language family / release metadata;
- semantic recall。
搜索再通过 Work ID 返回 Pages hydrate 正文。
这种三层结构比单一数据库复杂,但与 Corpus 的“所有派生层可重建”原则一致。
七、Crawl → Corpus:真正关键的是 Copy-on-Ingest
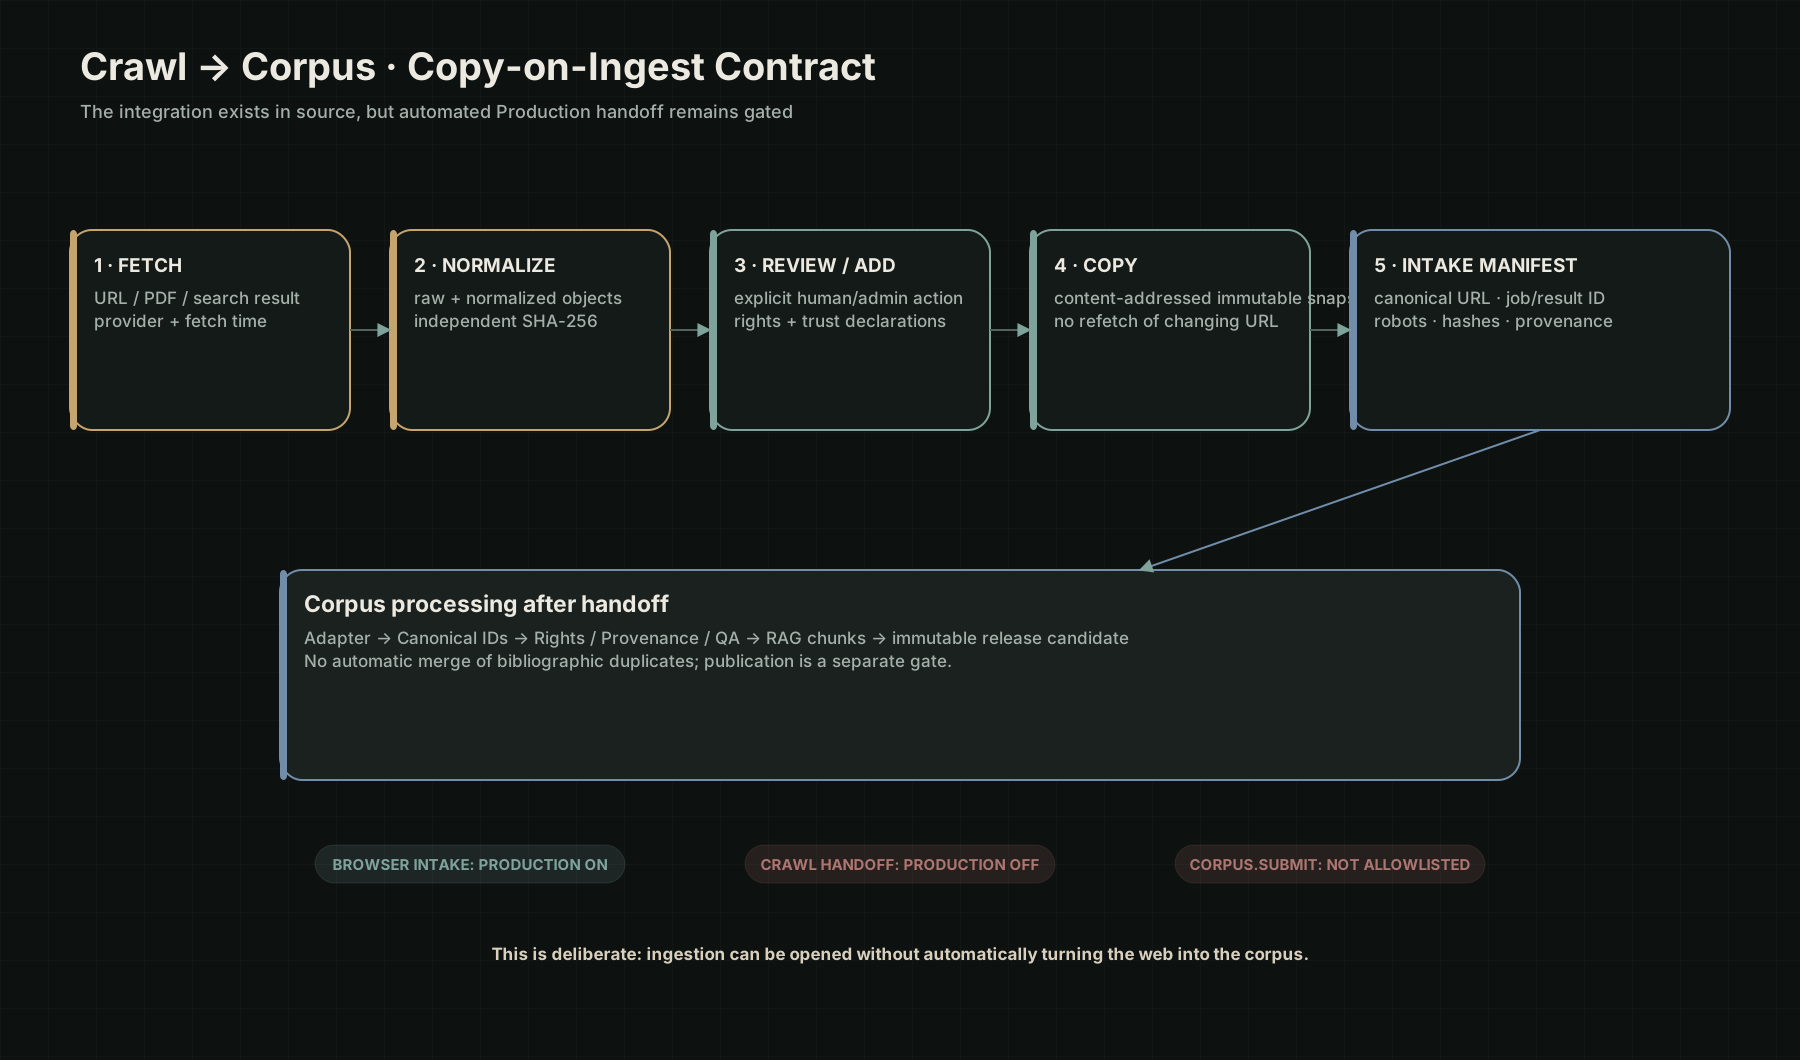
两者整合中最重要的设计不是一个 API 名称,而是 Copy-on-Ingest。
假设 Crawl 抓取:
1 | https://example.com/article |
当天得到正文 A。
如果 Corpus 只保存 URL,那么一个月后 Reader 或 RAG 再访问这个 URL,可能得到正文 B,甚至页面已经不存在。
这样 Corpus 的 Citation 就失去了稳定性。
所以设计变成:
1 | Crawl Result |
这意味着 Corpus 保存的是“当时经过确认要摄取的那个版本”,而不是一个未来会变化的引用。
7.1 当前 Production 边界
这里必须强调现实状态:
- Browser / Admin Intake:Production 已开启;
- Crawl Intake:Production 关闭;
corpus.submitAllowlist:关闭;- Publication:关闭。
所以当前系统并不是:
1 | Crawl → 自动进入 Corpus → 自动向量化 → 自动发布 |
而是:
1 | External / Admin source |
而 Crawl handoff 则已经有完整源代码契约和 Preview 前置设计,但尚未成为 Production 自动通路。
我认为这是现阶段正确的状态。
八、与其他 xHalo 模块的依赖关系
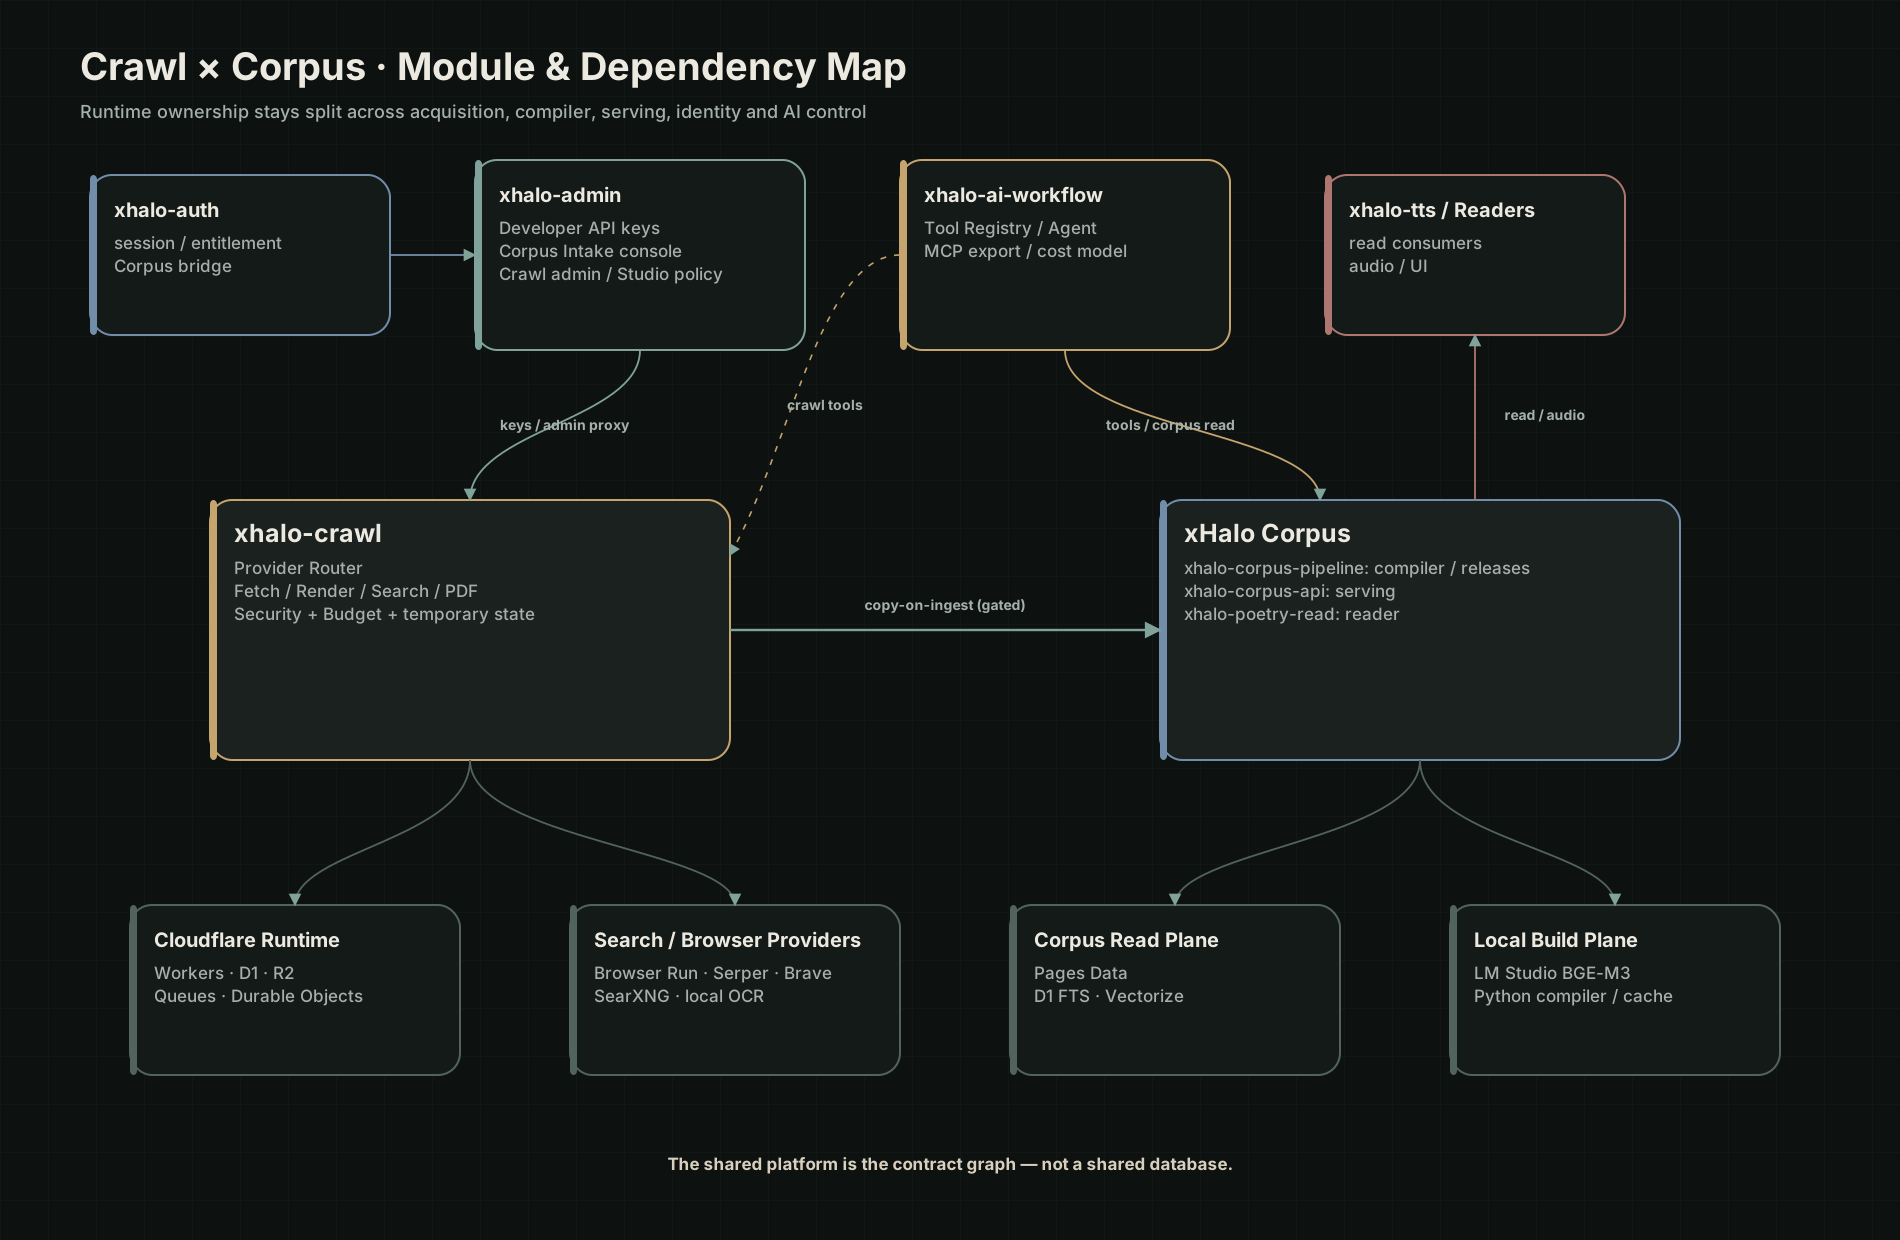
Crawl 与 Corpus 自身并不负责所有横向平台能力。
xhalo-auth
负责:
- User Identity;
- Session;
- Corpus session bridge;
- Entitlement。
Corpus Browser Intake 在 8 月 13 日开启后,浏览器并不是直接拿着 Intake secret 请求 Worker,而是:
1 | admin.xhalo.co |
这比在前端暴露 Intake Origin 或 Internal Secret 更合理。
xhalo-admin
负责:
- Developer API Key;
- Crawl 管理;
- Crawl Usage / Settings;
- Corpus Intake Console;
- Platform Admin BFF;
- 需要人工确认的管理操作。
因此 Crawl 与 Corpus 都没有再建设第二套 Admin。
xhalo-ai-workflow
负责:
- Tool Registry;
- Agent / Workflow;
- MCP Export;
- Model Cost;
- Context / Tool Policy。
它可以调用 Crawl 和 Corpus,但不应该拥有它们的 D1、R2 或 Canonical Data。
xhalo-tts / Reader / Story 等消费者
它们通过 Corpus API 或已发布 Tool 读取知识,不直接依赖构建 Pipeline 的内部格式。
这种关系意味着平台真正共享的是 Contract,而不是数据库。
九、分阶段实施过程:为什么这两套系统没有一次性“做大而全”
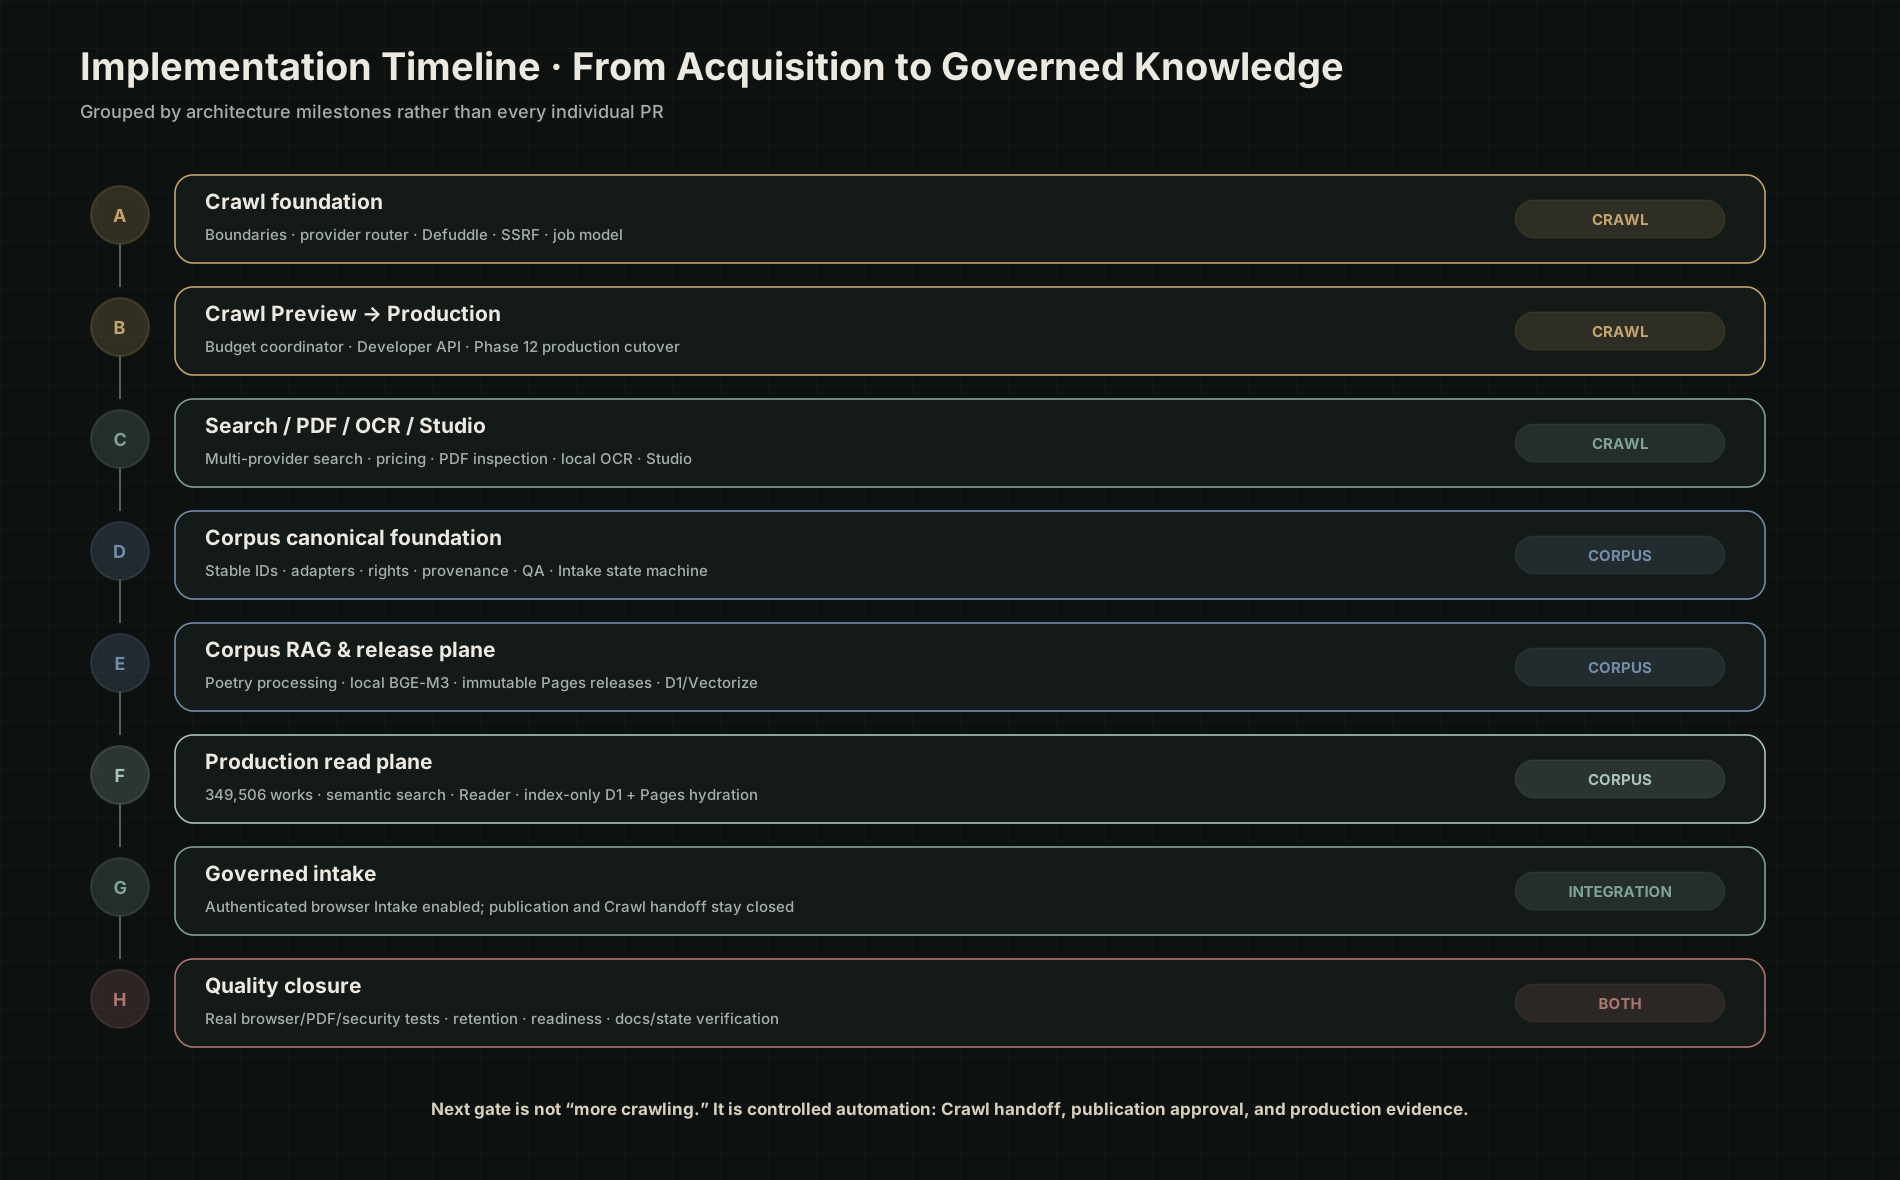
回看实施过程,可以把大量 PR 和 Phase 压缩成八个架构里程碑。
阶段 A:Crawl Foundation
最初先固定边界:
- Crawl 只负责 acquisition / normalization;
- Provider Router 在 Server;
- SSRF Guard;
- Job / Result;
- Defuddle normalization;
- 不建设第二套 Auth / Admin / MCP。
这个阶段的价值是防止 Crawl 从第一天就变成“浏览器自动化万能工具”。
阶段 B:Preview 与生产切换
之后补上:
- D1 / R2 / Queue;
- Browser Budget Coordinator;
- Developer API;
- Preview / Production 资源隔离;
- Release Safety;
- 2026-08-05 Phase 12 Production Cutover。
Crawl 到这里才真正成为生产服务。
阶段 C:Search / PDF / OCR / Studio
后续扩展包括:
- Search Gateway;
- Serper / Brave / SearXNG / xHalo RAG;
- Auto / Web / Knowledge / Hybrid modes;
- realtime / cost-sensitive / research profiles;
- Provider Deadline;
- Circuit Breaker;
- Pricing Ledger;
- PDF Inspect / Parse;
- Selective OCR;
- Crawl Studio。
这个阶段把 Crawl 从“抓 URL”扩展成完整 Web Context Service。
阶段 D:Corpus Canonical Foundation
Corpus 从一开始先解决结构问题:
- canonical entity;
- content tree;
- stable ID registry;
- aliases;
- source profile;
- rights;
- provenance;
- QA;
- Intake state machine。
而不是先做 UI 或向量库。
阶段 E:Poetry Processing 与 Local RAG
Poetry 成为第一个 reference domain:
- Chinese Poetry;
- Gutenberg;
- Standard Ebooks;
- Wikisource;
- parse / normalize;
- dedup candidate;
- Poetry chunk profile;
- 本地 LM Studio / BGE-M3;
- embedding cache;
- Vectorize NDJSON;
- Retrieval Benchmark。
这一步证明 Canonical Contract 可以承载真实内容域。
阶段 F:Immutable Release 与生产读平面
接下来建立:
- immutable
releases/<version>; - manifest;
- shard;
- lookup / browse / authors;
- latest pointer;
- integrity check;
- rollback;
- D1 FTS;
- Vectorize;
- Corpus API;
- Reader。
最终 Production Poetry Release 达到 349,506 Works。
阶段 G:Governed Intake
Intake Worker、R2、Queue、Workflow、Auth Bridge 和 Admin Console 逐步进入生产。
8 月 13 日,Production Browser Intake 正式打开,但其它写入边界继续保持:
1 | Browser Intake ON |
这个状态说明系统已经允许“把新东西送进处理系统”,但还没有允许“送进去就成为正式知识”。
阶段 H:Quality Closure / Final Closure
Crawl 后期大量工作已经不是开发新功能,而是重新验证已经存在的能力:
- 修 IDOR;
- 修 Studio CORS;
- 补 Search Provider deadline / circuit breaker;
- 修 Pricing Ledger;
- 补 PDF 二进制安全 fixture;
- 限制 OCR 并发;
- 加 Retention Cleanup;
- 对齐 OpenAPI / SDK;
- 真正实现
/ready; - 建 current-state.json 与文档一致性检查。
这是一个很明显的阶段变化:项目开始从“功能建设期”进入“证据与治理期”。
十、这两个项目目前做得最好的部分
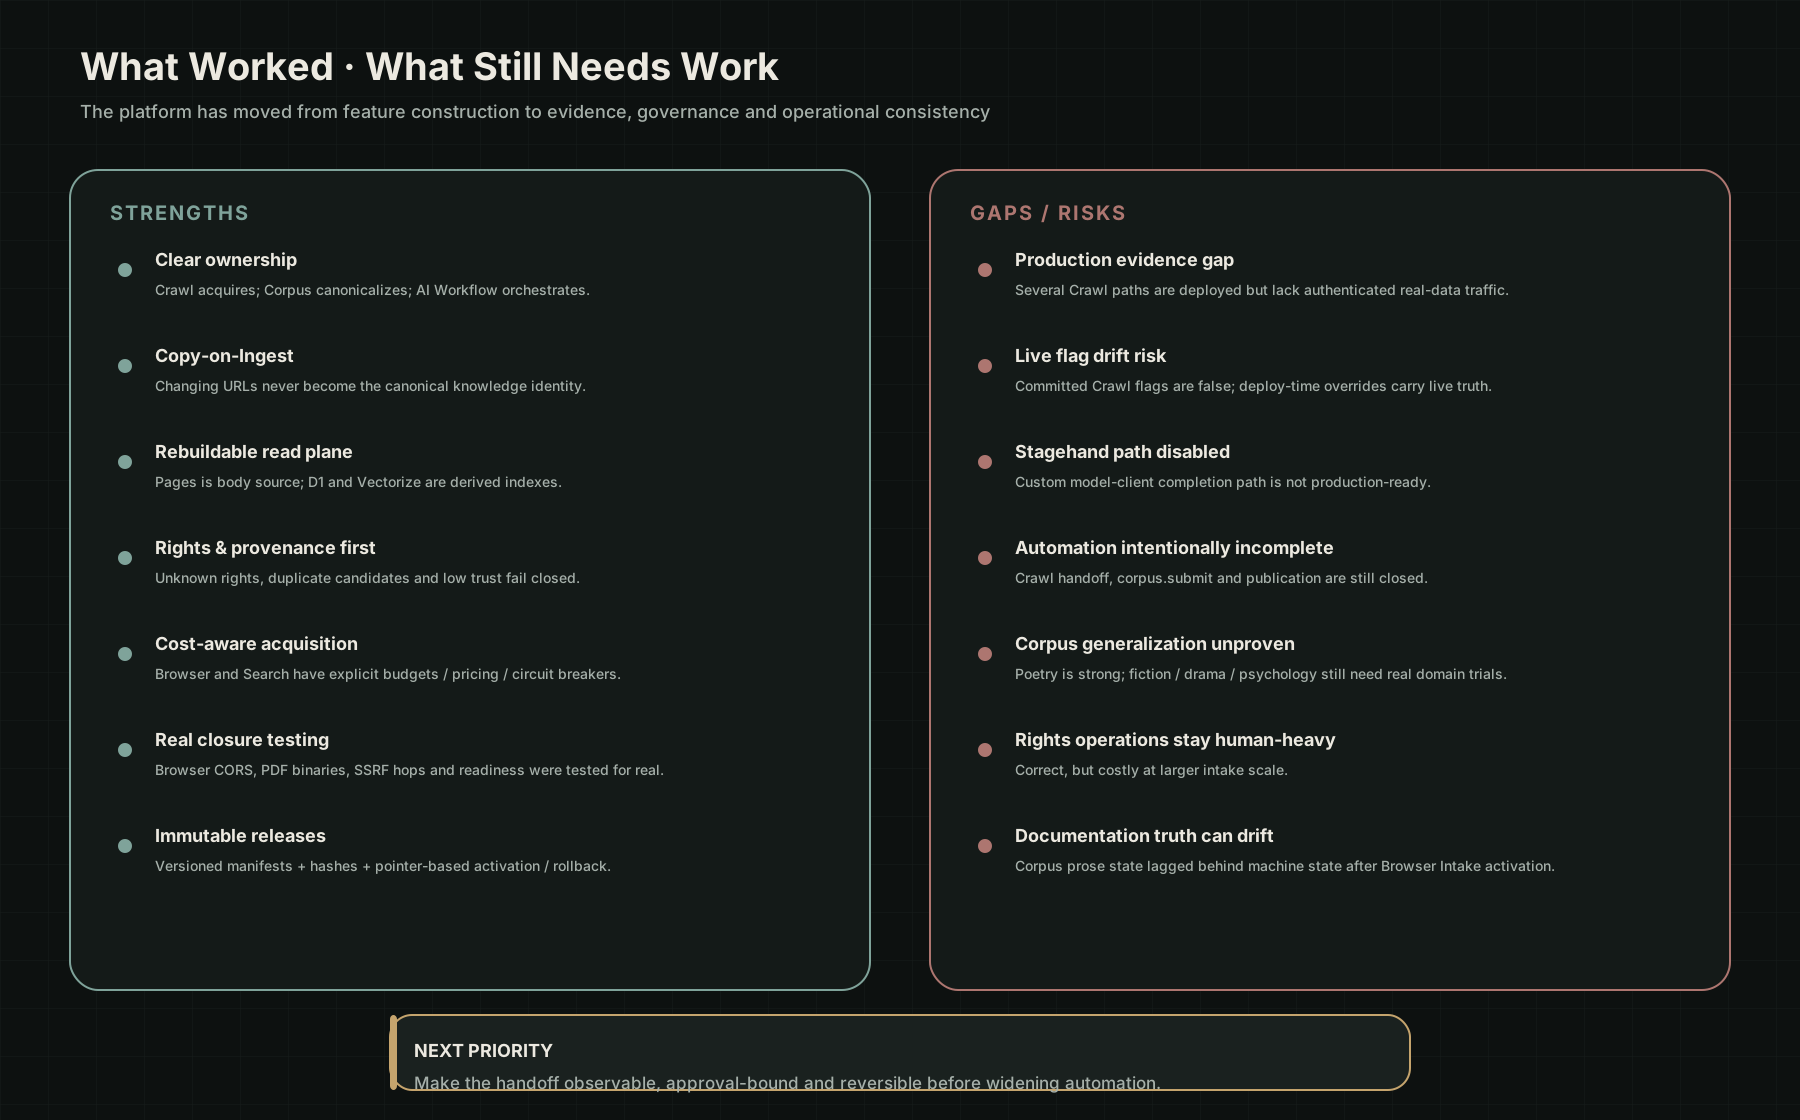
10.1 没有把 Crawl Result 当成 Canonical Data
这是整体最重要的正确决策。
Crawl 是 acquisition,Corpus 是 canonicalization。两个概念没有混在一起。
10.2 Copy-on-Ingest 解决了网页会变化的问题
Corpus 吸收的是一个经过 hash 固定的 Snapshot,而不是一个未来可能返回不同内容的 URL。
这使 Citation、RAG Evidence 和 Release 才真正稳定。
10.3 Corpus 的 Derived Layer 可重建
Pages 正文、D1 Index 和 Vectorize 各司其职。D1 / Vectorize 不成为正文的唯一事实源。
这降低了数据库锁定和长期迁移风险。
10.4 Rights / Provenance / QA 进入构建管线
这些不是 README 里的原则,而是决定 Candidate 是否可发布的真实 Gate。
10.5 Crawl 的成本治理已经进入 Runtime
Browser reservation / settlement、Search pricing ledger、deadline 和 circuit breaker 都比单纯记录 usage 更成熟。
10.6 Security Review 开始依赖真实失败案例
Studio CORS 是一个很典型的例子:之前 curl / Node 测试都没暴露浏览器跨域问题,真正浏览器验收才发现整个 Studio 从实际点击路径看并不可用。
这种 bug 很有价值,因为它推动测试从“API 返回 200”变成“用户真的能用”。
10.7 Immutable Release + Pointer Activation 很适合长期知识库
Release 本身不覆盖,Activation 只移动 pointer;Rollback 也只指回一个已经存在、完整性通过的 Release。
比直接更新“当前数据库内容”更容易审计和回滚。
十一、还需要加强的部分
11.1 Crawl 仍存在 Production Evidence Gap
目前多个能力是 production_deployed,但不是 production_verified。
尤其:
- Search real result content;
- async Crawl budget path;
- Jobs / Usage authenticated path;
- Hybrid / Research / Auto 某些模式的真实生产表现。
这意味着下一阶段不应该继续优先增加 Search Provider,而应该获得真实生产调用样本。
11.2 Crawl 的 Live Feature Flag 事实仍然过于依赖 deploy-time override
这是一个非常值得重视的风险。
仓库中的 wrangler.jsonc 仍然把大量 CRAWL_*_ENABLED 默认设为 false,真实 Production 则通过 deploy-time --var override 开启。
这样做的初衷是 fail closed,但副作用是:
一次不带完整 override 的普通
wrangler deploy,有可能把已经上线的能力重新关闭。
Final Closure 已经意识到这个问题,并在部署前从 live version 重建完整变量列表,但长期看这仍然不是最理想的 Deployment Truth 模型。
更好的方向是让 live capability state 有机器可验证、可生成部署参数的单一事实源,而不是依赖操作员记住“不能 bare deploy”。
11.3 Provider Router 的“架构宽度”目前大于真实可用宽度
设计上有:
1 | Direct |
但 Production 真实启用的是 Direct + Browser Run,Stagehand 当前明确 disabled,Crawl4AI / Scrapling 也关闭。
因此现阶段更准确的说法不是“五 Provider 自动路由已经成熟”,而是:
Provider Router 的抽象已经成熟,但真正稳定的 Production Provider 集合仍然较窄。
这并不是坏事,只需要文档和产品预期保持一致。
11.4 Stagehand 不应该为了“架构完整”被强行修复
真实诊断已经把早期“CDP WebSocket 问题”进一步缩小到自定义 Model Client completion-tracking 路径。
如果 Direct + Browser Run + Search 已经覆盖绝大部分需求,那么是否继续投入 Stagehand,应该由真实任务缺口决定,而不是因为架构图上预留了这个 Provider。
11.5 Corpus 的自动化写平面仍然没有闭环
当前 Browser Intake 已经 Production enabled,但:
- Crawl handoff 关闭;
corpus.submit关闭;- Publication 关闭。
这意味着 Corpus 还没有形成完整的“外部发现 → 自动候选 → 审核 → 发布”运营闭环。
这应该是下一阶段最值得推进的一条链,但仍然不应该直接跳到自动 publish。
11.6 Poetry 的成功还不能证明所有 Corpus Domain 都已验证
Corpus Contract 的目标是复用于:
- Fiction;
- Drama;
- Screenplay;
- Psychology;
- Private Corpus。
但当前真正经过 349,506 Works 规模验证的是 Poetry。
长篇小说、章节树、脚本角色、心理学著作的引用单位、Rights 粒度、Chunk Profile 和 Edition 关系都可能不同。
所以 Corpus Platform 的下一项关键验证,不应该只是“再导入更多诗”,而是选择一个结构差异明显的第二 Domain。
11.7 Rights / Duplicate Review 的人工成本会随规模迅速增加
当前“zero automatic merge”是正确的安全边界,但随着数据源增加,人工 review candidate 数量可能成为瓶颈。
后续应该提高的是 Review tooling 和 evidence quality,而不是简单放宽自动 merge。
11.8 Corpus 状态文档已经出现一次真实 Drift
这是本次复盘发现的一个具体例子。
docs/CURRENT_STATE.md 的 prose 仍写着截至 8 月 12 日 Browser Intake 关闭,而 8 月 13 日的 docs/current-state.json 与真实提交已经把:
1 | production_browser_intake = true |
正式打开。
也就是说项目已经有机器状态源,但人读状态页仍可能落后。
这和 Crawl 后期花大量精力解决的 Documentation State Governance 是同一类问题。
下一步应该让 prose summary 尽量由 machine state 生成,而不是维护两份手写真相。
十二、成本与性能复盘
这两个项目有一个共同特点:并没有把“全部 Cloudflare 服务都用上”当成架构目标,而是在不同阶段把负载放到更适合的层。
Crawl
- 普通网页优先 Direct Fetch;
- JS-heavy 才进入 Browser;
- Browser 有 included-only / budget gate;
- Search 有 Provider Cost Profile;
- OCR 放在已有 Oracle ARM 上,并限制并发;
- R2 用于临时对象和内容寻址缓存;
- D1 保存 job、usage、pricing、audit,而不是大正文。
Corpus
- 大规模不可变正文放 Pages Data;
- D1 变成 index-only;
- Vectorize 只负责 semantic retrieval;
- Embedding 用本地 LM Studio / BGE-M3 构建;
- SQLite cache 复用 unchanged text 的 vector;
- Release embedding 以 immutable batch + SHA checkpoint 方式可恢复上传。
这套架构的共同逻辑其实是:
把昂贵、动态的事情尽量限制在 ingestion/build 阶段,把生产读取变成廉价、缓存友好、可预测的路径。
这是 Corpus 当前能够承载 349,506 Works 而不必把所有正文塞进运行时数据库的重要原因。
十三、下一阶段建议:重点不是继续“加功能”,而是闭合四条链
P0:统一 Runtime Truth
首先解决:
1 | Source config |
之间的事实一致性。
尤其 Crawl 的 deploy-time feature flags,应从机器状态安全生成 Deploy Manifest,降低 bare deploy 误关闭能力的风险。
P1:建立安全的 Production Verification Principal
当前很多 Production Evidence 缺口都卡在“没有一个安全、短期、可审计的真实测试身份”。
应该设计一个真正的:
1 | production-smoke principal |
而不是要求每次用真实个人 Developer API Key,或为了测试临时关闭生产 Auth。
P2:推进 Crawl → Corpus Preview 自动 Handoff
已经有 Source Contract,下一步应该验证:
1 | Crawl Result |
重点测试:
- approval expiry;
- duplicate request;
- hash mismatch;
- changed URL;
- revoked actor;
- rights rejection;
- concurrent handoff;
- rollback。
P3:Publication 继续作为独立 Gate
即使 Crawl Handoff 可以自动触发 Intake,也不要直接把:
1 | processed → published |
变成同一步。
正确链路更接近:
1 | intake |
P4:用第二个 Domain 验证 Corpus Generalization
建议选择和 Poetry 差异明显的一个领域,例如:
- 长篇 Fiction;或
- Drama / Screenplay。
验证:
- 章节层级;
- 长文本 chunk;
- Edition / translation;
- Character / Scene 结构;
- Citation;
- Rights component;
- Reader hydration;
- RAG retrieval。
这比继续扩大 Poetry 数量更能证明 Corpus Platform 的通用性。
P5:统一 Crawl / Corpus Trace
最终一条知识可以回答:
1 | 这个 Corpus Work |
这才是一个真正可审计的知识平台。
十四、总结:真正的产物不是爬虫,也不是向量库
回看 Crawl 和 Corpus 的建设过程,最容易被外部观察到的能力其实都不是最重要的:
- Browser Run;
- Search;
- PDF;
- OCR;
- Vectorize;
- BGE-M3;
- Reader;
- RAG。
这些都只是系统组件。
真正决定这两个项目长期价值的,是下面三条边界:
第一条:Crawl 不拥有知识真相
它提供的是一次受约束、可审计的外部 acquisition result。
第二条:Corpus 不信任“已经抓到了”
只有经过 Stable ID、Rights、Provenance、QA、Release 和 Citation 的内容,才进入长期知识平面。
第三条:自动化不能绕过 Publication Authority
即使未来 AI Workflow、Agent、Crawl 能自动发现和摄取大量资料,最终“什么成为 xHalo 的正式知识资产”仍然应该经过独立、可追踪、可回滚的发布门。
因此现阶段最准确的架构描述不是:
xHalo 已经有一个很强的爬虫和一个大型 RAG 库。
而是:
xHalo 正在形成一条从外部世界到 Canonical Knowledge 的受治理数据管线:Crawl 负责 acquisition,Corpus 负责 canonicalization,AI Workflow 负责 orchestration,而最终 Publication 仍然保持独立权限。
这条边界如果能够继续保持,未来无论加入文学、剧本、心理学、哲学、News、Map 还是用户私有资料,都可以复用同一条知识治理逻辑,而不必再次退回“抓数据 → 切 Chunk → 塞向量库”的临时方案。